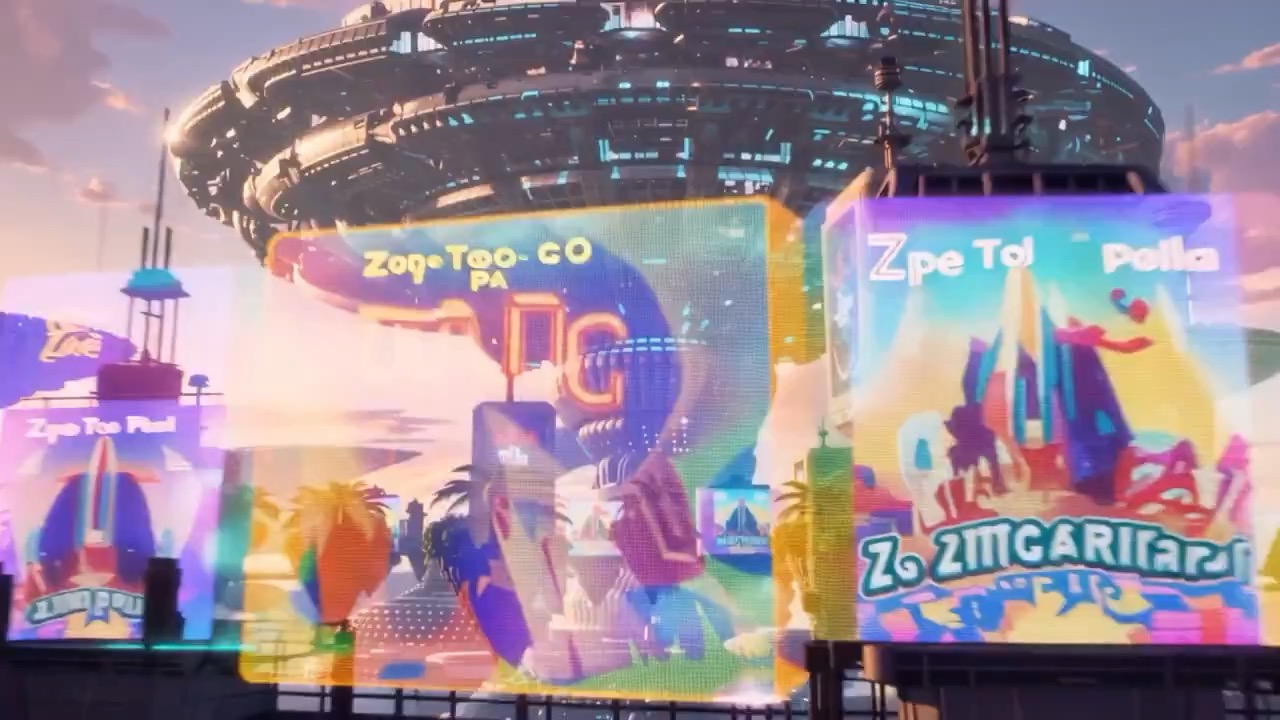Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता।
Triple mode: text-to-video + image-to-video + video-to-video एक साथएक heavy Wan option जो केवल text या still images के बजाय source video से भी start कर सकता है
ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें।
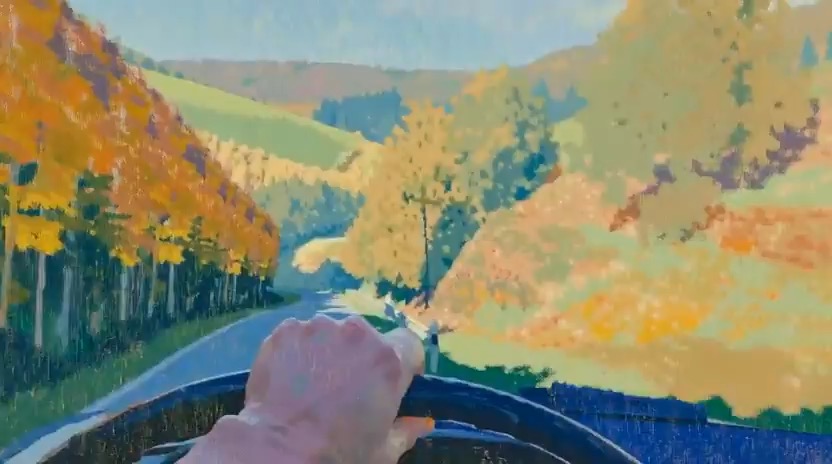
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · वनाच्छादित पहाड़ियों में तेलचित्र ड्राइव का प्रीव्यू, दृश्य सेटअप, कैमरा पथ, गति निरंतरता, संपादन योग्य विवरण और अंतिम मुख्य फ्रेम पर केंद्रित।
पहले मौजूदा उपलब्धता, इनपुट, आउटपुट, क्रेडिट और उपलब्ध उदाहरण जाँचें। ऑनलाइन परीक्षण उपलब्ध हो तो मॉडल को इसी पेज पर आज़माएँ; सहेजे गए इतिहास, सामग्री और लंबे काम के लिए Studio का उपयोग करें।
उदाहरण आउटपुट
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · वनाच्छादित पहाड़ियों में तेलचित्र ड्राइव का प्रीव्यू, दृश्य सेटअप, कैमरा पथ, गति निरंतरता, संपादन योग्य विवरण और अंतिम मुख्य फ्रेम पर केंद्रित।
इनके लिए उपयोगी
Existing source clip से video-to-video editsText और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।Flexible Wan project से stills animate करनाText, image और video inputs में iterative motion tests
समर्थित
टेक्स्ट से वीडियोइमेज से वीडियोवीडियो से वीडियो
ऑनलाइन परीक्षण
Wan 2.6 इस्तेमाल करें
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं। Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता।
परिणाम
अभी कोई परिणाम नहीं है। रन शुरू करने के लिए प्रॉम्प्ट सबमिट करें।
ऊपर ऑनलाइन परीक्षण इस्तेमाल करें, फिर Studio में ज्यादा क्रेडिट खर्च करने से पहले अंतिम रूप, लय और कार्य के लिए उपयुक्तता समझने के लिए इन उदाहरणों की तुलना करें।
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · वनाच्छादित पहाड़ियों में तेलचित्र ड्राइव का प्रीव्यू, दृश्य सेटअप, कैमरा पथ, गति निरंतरता, संपादन योग्य विवरण और अंतिम मुख्य फ्रेम पर केंद्रित।
गति लय, विषय निरंतरता, कैमरा दिशा और अंतिम मुख्य फ्रेम दिखाता वनाच्छादित पहाड़ियों में तेलचित्र ड्राइव वीडियो प्रीव्यू।
इनपुट
अधिकतम 3 संदर्भ फ़ाइलें
किस पर ध्यान दें
गति लय, विषय निरंतरता, कैमरा दिशा और अंतिम मुख्य फ्रेम दिखाता वनाच्छादित पहाड़ियों में तेलचित्र ड्राइव वीडियो प्रीव्यू।
Triple mode: text-to-video + image-to-video + video-to-video एक साथ
एक heavy Wan option जो केवल text या still images के बजाय source video से भी start कर सकता है
ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें।
सबसे उपयुक्त कार्य
सबसे उपयुक्त कार्य
Existing source clip से video-to-video editsText और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।Flexible Wan project से stills animate करनाText, image और video inputs में iterative motion tests
मॉडल प्रमाण
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · कक्षीय मेगास्ट्रक्चर सूर्यास्त शॉट का पूर्वावलोकन क्लिप, जो क्षितिज सेटअप, parallax reveal, पढ़ने योग्य पैमाना, संपादन योग्य रंग तापमान और अंतिम hero frame पर केंद्रित है।
कक्षीय मेगास्ट्रक्चर सूर्यास्त वीडियो पूर्वावलोकन, जिसमें शांत क्षितिज, घुमावदार संरचना reveal, नरम गुलाबी-नीली रोशनी, कैमरा drift और अंतिम चौड़ा hero frame दिखता है।
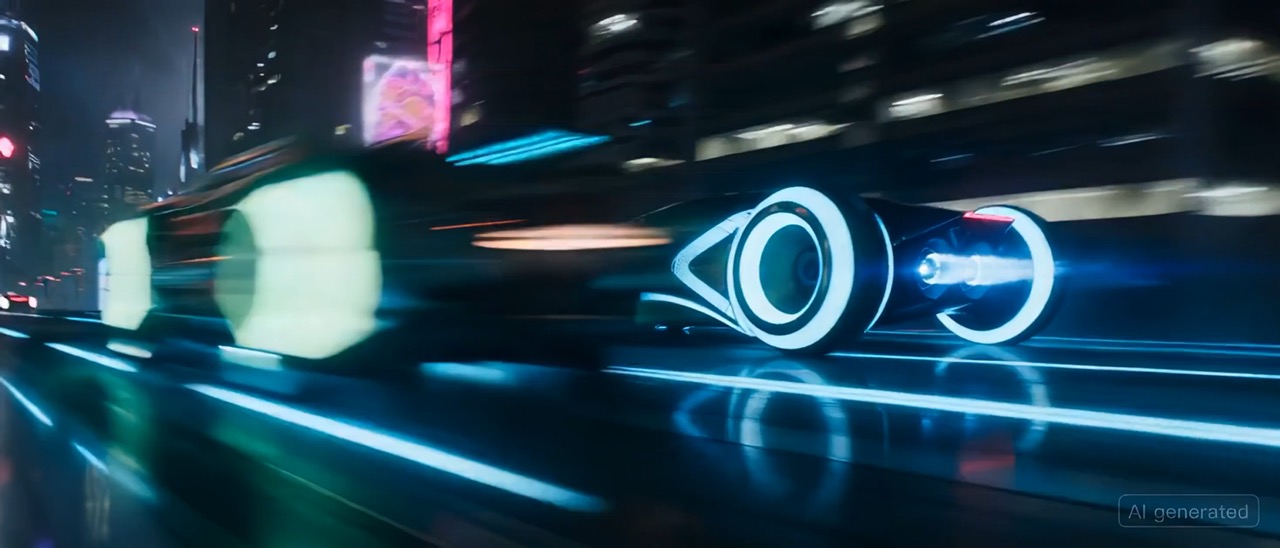
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · Elevated-road geometry, near-pass motion, traffic depth, vehicle scale और readable wide ending पर केंद्रित preview.
Layered elevated traffic के बीच चलती original speeder दिखाने वाला sci-fi future city video preview.
चुनाव के लिए उपयुक्तता
यह मॉडल कब सही चुनाव है
चुनाव के लिए उपयुक्तता
उपयुक्तता संकेत
Triple mode: text-to-video + image-to-video + video-to-video एक साथ
एक heavy Wan option जो केवल text या still images के बजाय source video से भी start कर सकता है
ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें।
अक्सर पूछे जाने वाले सवाल
Wan 2.6 के अक्सर पूछे जाने वाले सवाल
Wan 2.6 असल में किस तरह के video work के लिए सबसे अच्छा fit है?
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।
Rivya पर Wan 2.6 का अभी वास्तविक दायरा क्या है?
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं। Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता।
Wan 2.6 का source-video path कब इसे चुनने की real वजह बनता है?
Source-video path Wan 2.6 पर step up करने की main reason तब है जब existing clip में already motion, timing या blocking worth preserving हो। अगर आपके पास सबसे strong asset clip itself है, सिर्फ written shot description नहीं, तो Wan 2.6 justify करना आसान हो जाता है क्योंकि आप scene scratch से rebuild करने के बजाय footage से steer कर रहे हैं।
Wan 2.6 अपने मौजूदा credit tier में कब worth है?
Wan 2.6 अभी `720p 5s = 70`, `720p 10s = 140`, `720p 15s = 210`, `1080p 5s = 105`, `1080p 10s = 210` और `1080p 15s = 315` credits पर priced है। यह tier तब sense बनाता है जब flexibility itself work बचा रही हो, खासकर जब same model first generation, still-led motion और source-video rework को एक option में cover कर रहा हो। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।
Wan 2.7 या narrower option के बजाय Wan 2.6 कब चुनना चाहिए?
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।
इस page पर पहले क्या test कर सकता हूं?
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें।
इस page पर क्या set up कर सकता हूं?
Wan 2.6 बिना media के text-to-video, ठीक 1 image के साथ image-to-video और 1–3 videos के साथ video editing सपोर्ट करता है; images और videos को मिलाया नहीं जा सकता। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं। Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता।
Run करने से पहले कौन से checks करने लायक हैं?
Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता। ठीक 1 JPG/PNG/WebP image (कम से कम 256×256, अधिकतम 10 MB) या 1–3 MP4/MOV videos (हर file अधिकतम 10 MB) इस्तेमाल करें।
यहां run करने से पहले क्या sign in जरूरी है, और credits कैसे काम करते हैं?
Page public है, लेकिन actual video run अभी भी sign in के पीछे है। Pricing अभी visible ladder follow करती है: `720p 5s = 70`, `720p 10s = 140`, `720p 15s = 210`, `1080p 5s = 105`, `1080p 10s = 210` और `1080p 15s = 315` credits। आप right source path, duration और resolution पहले चुन सकते हैं, फिर run करने के लिए ready होने पर sign in करें। Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।
मुझे इस page पर कब रहना चाहिए, और पूरे Studio में कब जाना चाहिए?
इस page पर तब तक रहें जब तक आप Wan 2.6 पर first source path और first cost tier validate कर रहे हों। Saved versions, repeated clip iterations, multiple coordinated assets या same footage या scene set around longer managed project चाहिए तो full Studio खोलें।
विकल्पों की तुलना करें
आगे विचार करने के लिए अन्य मॉडल
वीडियो
Seedance 2.5
Seedance 2.5 केवल प्रॉम्प्ट वाले वीडियो, पहले और अंतिम फ्रेम के मार्गदर्शन, बहुमाध्यमी रेफरेंस और वीडियो-निर्देशित रूपांतरण के लिए Rivya का बड़ा Seedance कार्यप्रवाह है। Mini की तुलना में इसमें 1080p स्तर, 30 सेकंड तक आउटपुट, स्वचालित अवधि, MP4 या MOV आउटपुट और इमेज, वीडियो तथा ऑडियो रेफरेंस की कहीं अधिक क्षमता मिलती है।
इस पर क्यों विचार करें
जब आपके अगले कार्य में अधिकतम 50 संदर्भ फ़ाइलें चाहिए हो, तो इस पर विचार करें।
ByteDance का full Seedance 2.0 video model, जिसमें prompt-only generation, frame-driven animation और multimodal reference generation के लिए साफ support है। Rivya documented role split को explicit रखता है ताकि frame inputs और multimodal references एक ambiguous upload bucket में collapse न हों।
इस पर क्यों विचार करें
जब आपके अगले कार्य में प्रॉम्प्ट, फ्रेम या इमेज/वीडियो/ऑडियो संदर्भ चाहिए हो, तो इस पर विचार करें।
इनके लिए उपयोगीPrompts, frames या reference bundles से higher-quality short videos
वीडियो
Seedance 2.0 Fast
ByteDance का faster Seedance 2.0 video model, जो prompt-only generation, frame-driven image animation और multimodal reference video generation के लिए full scene routing देता है। Rivya documented scene split को explicit रखता है ताकि first/last-frame inputs reference image, video और audio roles से collide न करें।
इस पर क्यों विचार करें
जब आपके अगले कार्य में प्रॉम्प्ट, फ्रेम या इमेज/वीडियो/ऑडियो संदर्भ चाहिए हो, तो इस पर विचार करें।
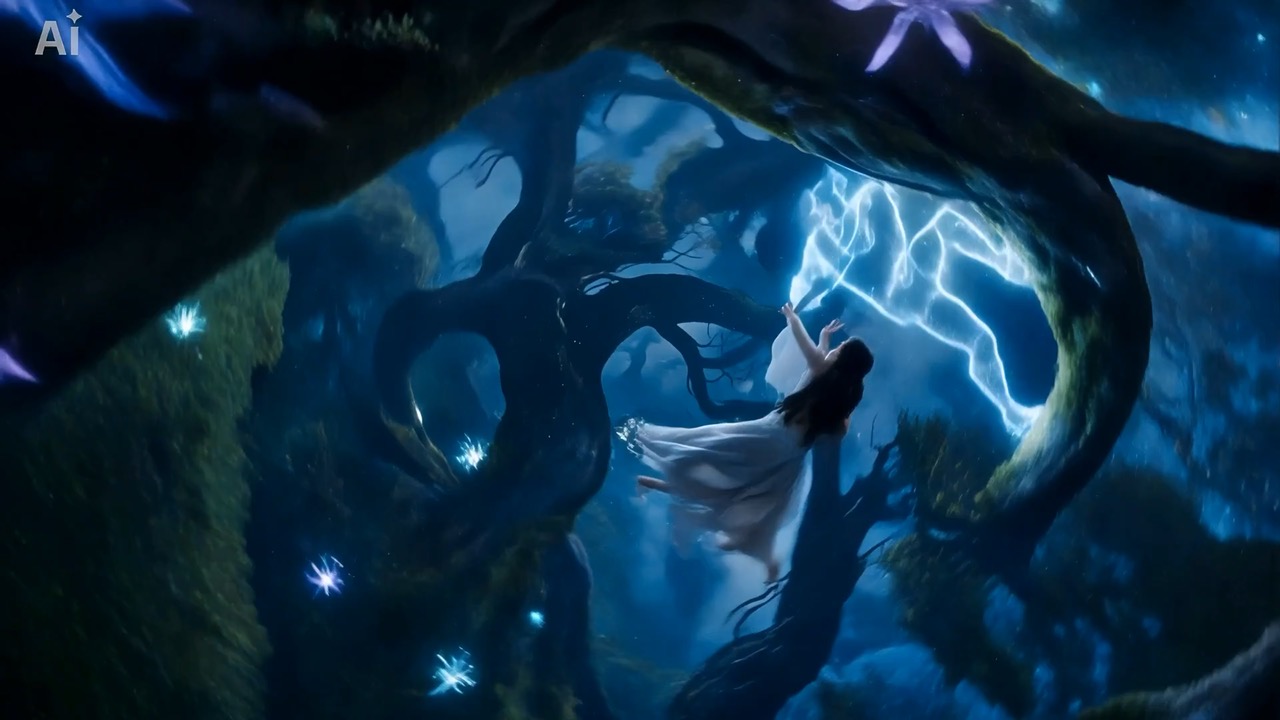
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · आधी रात धुंधले जंगल पथिक ब्रीफ का प्रीव्यू क्लिप, जिसमें धुंध की गहराई, पात्र की गति, सूक्ष्म रोशनी और अंतिम रिवील कंपोजिशन पर ध्यान है.
आधी रात धुंधले जंगल का वीडियो प्रीव्यू, जिसमें चोगा पहना पथिक चांदनी धुंध से गुजर रहा है.
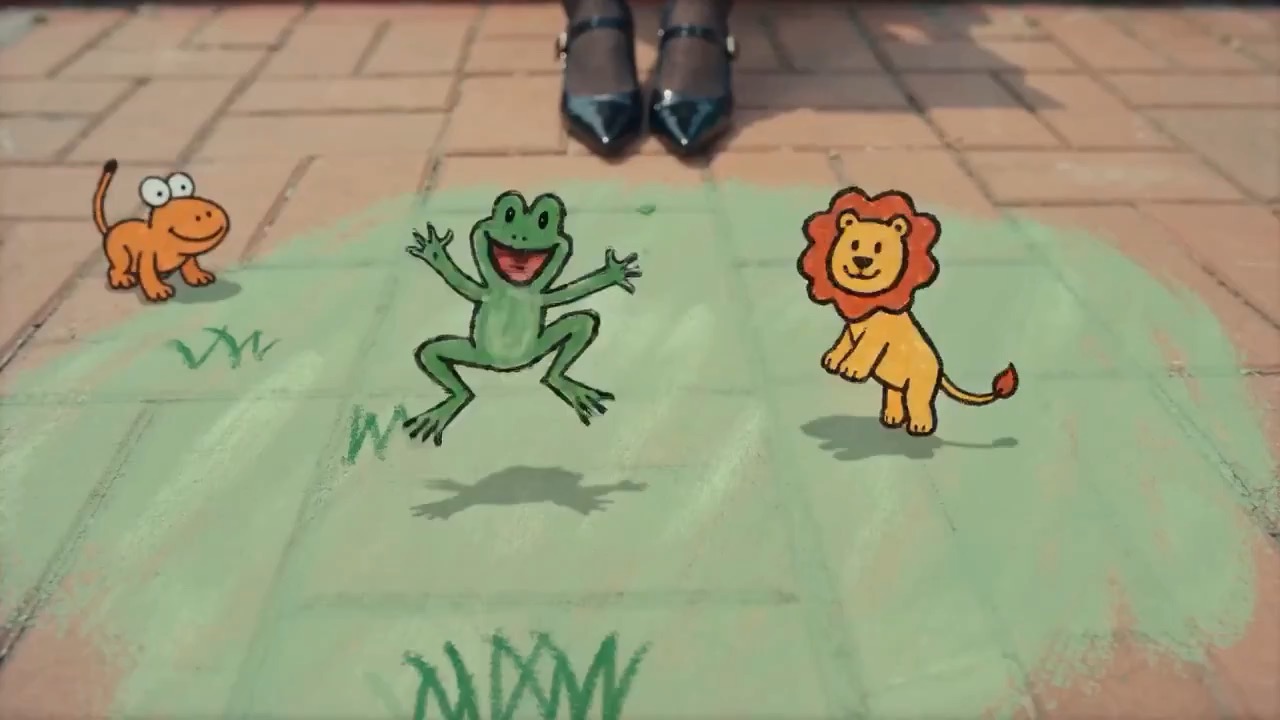
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · Page-turn continuity, handmade animation, outdoor light और final book composition पर केंद्रित hand-drawn storybook pop-up shot preview.
Open book से उठते animated paper animals वाला hand-drawn storybook pop-up video preview.
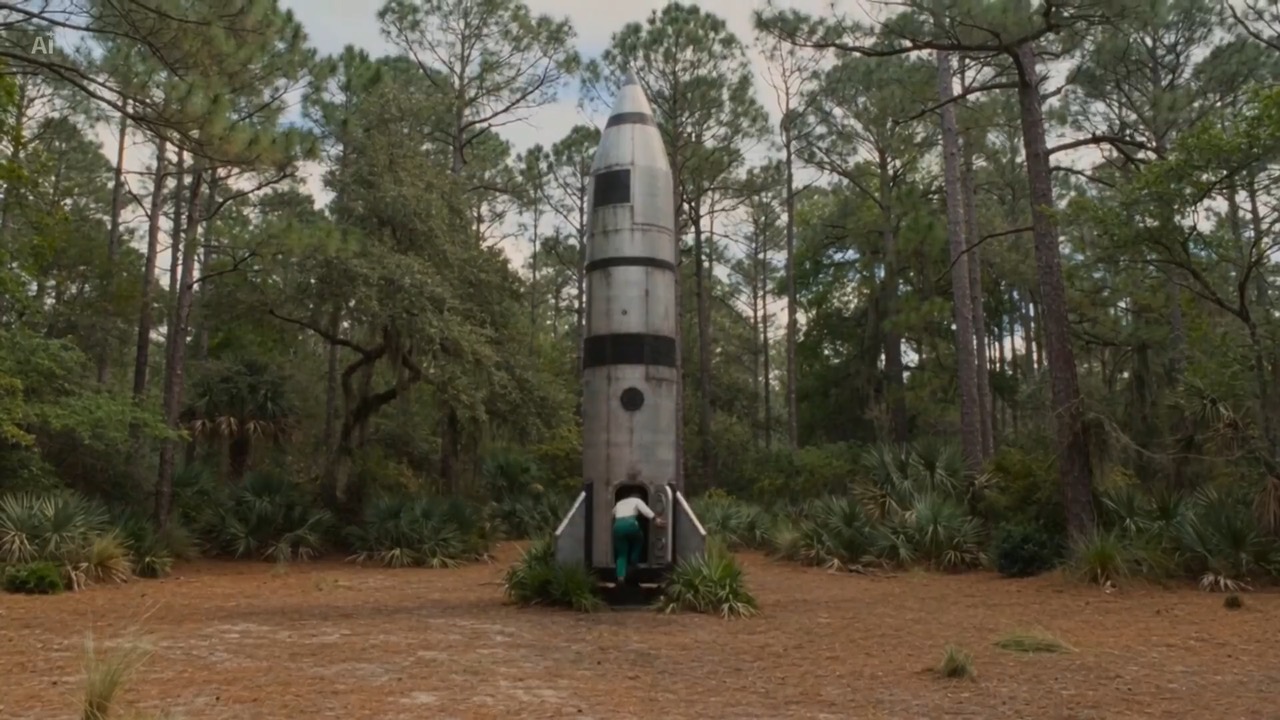
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · path motion, rocket scale, boarding continuity और vertical liftoff पर केंद्रित preview clip.
Forest action video preview, जिसमें runner clearing में enter करता है और compact rocket में launch होता है।
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · कक्षीय मेगास्ट्रक्चर सूर्यास्त शॉट का पूर्वावलोकन क्लिप, जो क्षितिज सेटअप, parallax reveal, पढ़ने योग्य पैमाना, संपादन योग्य रंग तापमान और अंतिम hero frame पर केंद्रित है।
कक्षीय मेगास्ट्रक्चर सूर्यास्त वीडियो पूर्वावलोकन, जिसमें शांत क्षितिज, घुमावदार संरचना reveal, नरम गुलाबी-नीली रोशनी, कैमरा drift और अंतिम चौड़ा hero frame दिखता है।
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · Elevated-road geometry, near-pass motion, traffic depth, vehicle scale और readable wide ending पर केंद्रित preview.
Layered elevated traffic के बीच चलती original speeder दिखाने वाला sci-fi future city video preview.
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · आधी रात धुंधले जंगल पथिक ब्रीफ का प्रीव्यू क्लिप, जिसमें धुंध की गहराई, पात्र की गति, सूक्ष्म रोशनी और अंतिम रिवील कंपोजिशन पर ध्यान है.
आधी रात धुंधले जंगल का वीडियो प्रीव्यू, जिसमें चोगा पहना पथिक चांदनी धुंध से गुजर रहा है.
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · Page-turn continuity, handmade animation, outdoor light और final book composition पर केंद्रित hand-drawn storybook pop-up shot preview.
Open book से उठते animated paper animals वाला hand-drawn storybook pop-up video preview.
उदाहरण; बनाने वाले मॉडल की पुष्टि नहीं हुई है · path motion, rocket scale, boarding continuity और vertical liftoff पर केंद्रित preview clip.
Forest action video preview, जिसमें runner clearing में enter करता है और compact rocket में launch होता है।
Text और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।
Default 1080p, 5 seconds, shot mode Off और content filter On है। दोनों controls साफ तौर पर भेजे जाते हैं और audio track generate नहीं होता।
सबसे उपयुक्त कार्य
कार्य ऐसा हो तो इसका उपयोग करें
Existing source clip से video-to-video editsText और image input में 5, 10 या 15 seconds मिलते हैं; video input में केवल 5 या 10 seconds मिलते हैं।Flexible Wan project से stills animate करनाText, image और video inputs में iterative motion testsऐसी teams जिन्हें generation और source-video rework के लिए एक model चाहिए
स्पष्ट तथ्य
इनपुट, आउटपुट और क्रेडिट की पुष्टि करें
प्रदाता
Alibaba
श्रेणी
वीडियो
क्षमताएँ
टेक्स्ट से वीडियो · इमेज से वीडियो · वीडियो से वीडियो
Wan 2.6 में कॉल किए जा सकने वाले Public API मोड हैं, लेकिन संदर्भ मीडिया मोड को अभी Files API अपलोड समर्थन चाहिए। सबमिट करने से पहले मॉडल संदर्भ देखें।