10.1秒
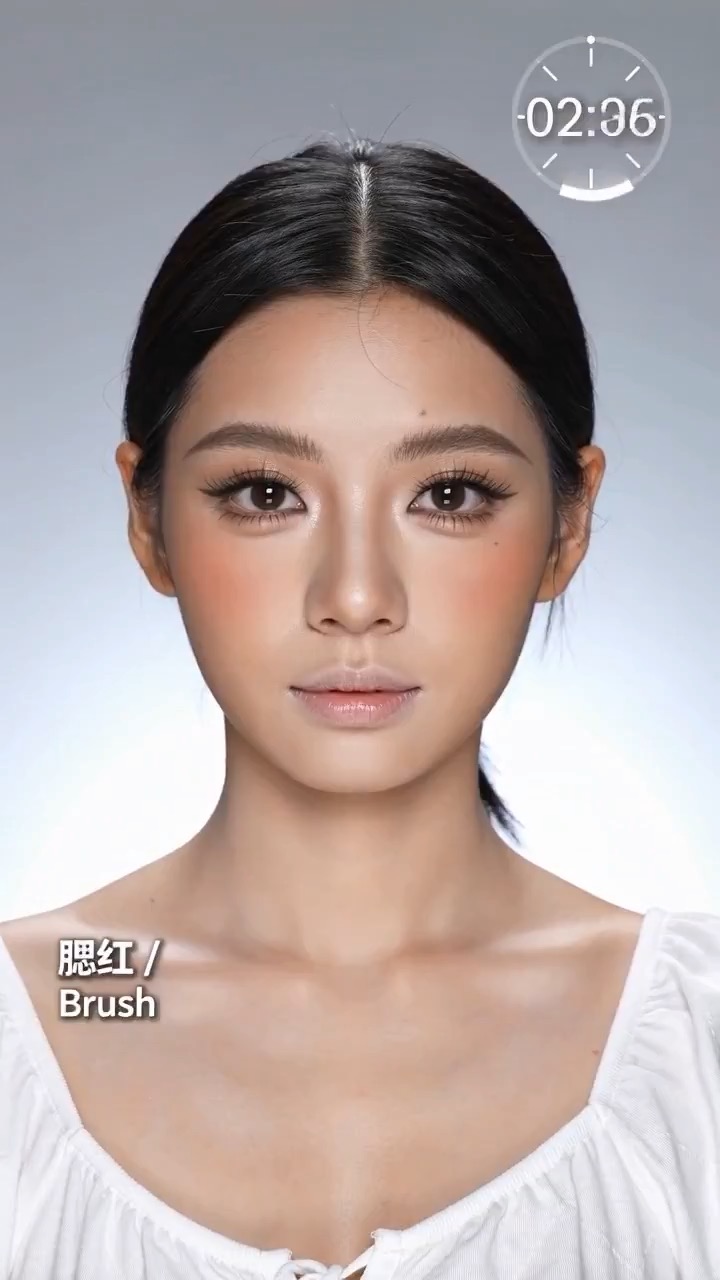
快速美妆变身视频预览,展示成年美妆创作者、无品牌化妆台、刷具近景、顺滑过渡和最终完成妆。
视频简报:成年美妆创作者 / 无品牌化妆台 / 刷具近景 / 顺滑前后过渡 / 精致完成妆
Kling AI Avatar Standard 是 Rivya 里的低成本 AI 数字人口播模型,适合把 1 张人物图和 1 段音频生成带口型同步的主持人视频。
任务最终消耗向上取整到整数积分。
示例输出
示例,生成模型尚未核实 · 快速美妆变身短片预览,重点呈现可读美妆动作、身份连续、无品牌产品和精致社交视频收尾。
数字人口播 · 图片+音频驱动
示例输出
示例,生成模型尚未核实 · 快速美妆变身短片预览,重点呈现可读美妆动作、身份连续、无品牌产品和精致社交视频收尾。
适合任务
支持能力
在线试用
暂时还没有可显示的结果。
提示词起步
模型示例
浏览模板预览,寻找创作方向。每条说明会标明是否已核实由该模型生成。
示例,生成模型尚未核实 · 快速美妆变身短片预览,重点呈现可读美妆动作、身份连续、无品牌产品和精致社交视频收尾。
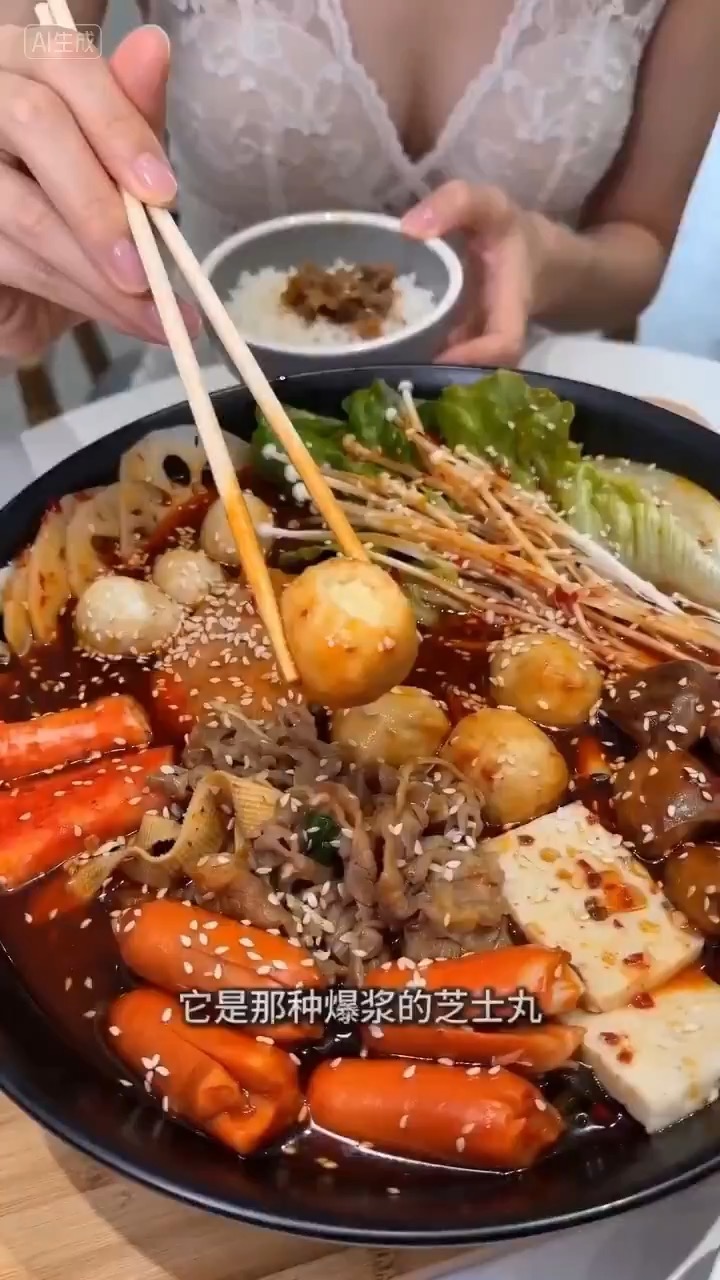
示例,生成模型尚未核实 · 美食主持人展示可编辑食品,安全试吃并自然反应,最后停在清晰的主持人与产品画面。
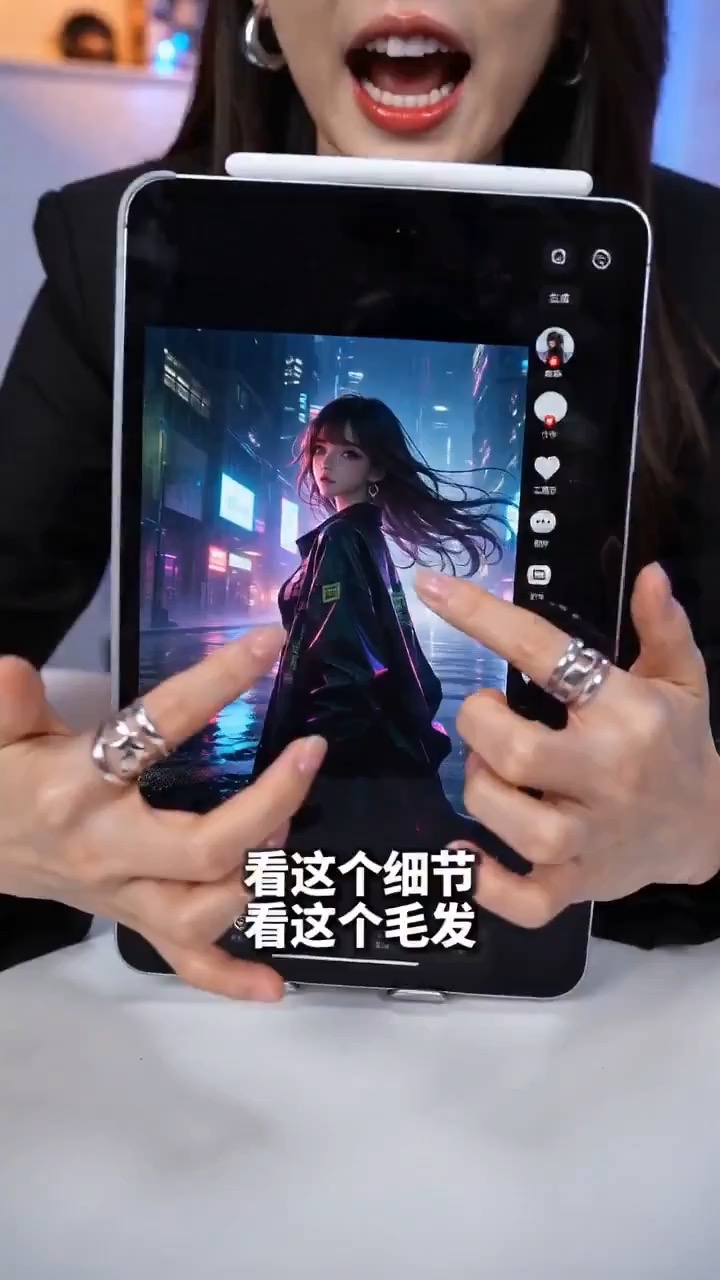
示例,生成模型尚未核实 · 直播电商演示主播视频简报预览,重点呈现场景设置、镜头路径、面部动作连续性、可编辑细节和最终主画面。
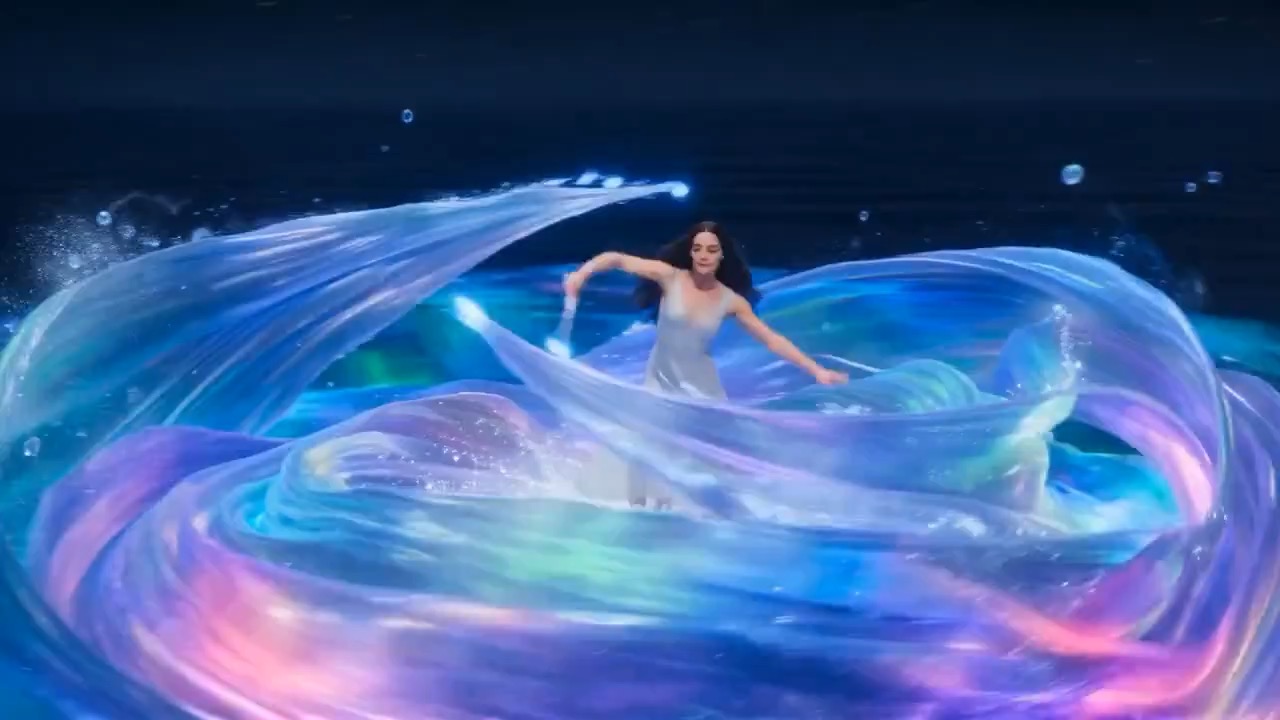
示例,生成模型尚未核实 · 可编辑舞者踏过发光海水,用动作带出光带,并在月光海面上停成安静姿态。
决策确认
决策确认
Kling AI Avatar Standard 常见问题
如果这条视频本身就适合用 1 张人物图加 1 段音频完成,Kling AI Avatar Standard 会更合适。它更适合简单数字人口播、内部说明、低风险的主持人口播短片这类任务,重点不是追求最精致的高级感,而是使用 8 积分 / 秒的 Standard 档位先获得一版可用结果。
在 Rivya 里,这个选项的范围很明确:1 张人物图、最长 300 秒的 1 段音频,再加一条可选提示词。系统按经验证的音频时长以 8 积分 / 秒计费,总积分向上取整。
最关键的通常不是参数,而是素材本身。只要人物图正脸清楚、嘴部没有遮挡、人物形象就是你想保留的那个版本,音频也已经是可以直接拿来用的那一条,Standard 往往就够了。如果这条内容更偏品牌发布或你对成片质感更挑剔,那就更值得往 Pro 走。
Rivya 按经验证的音频时长以 8 积分 / 秒计费,音频最长 300 秒,总积分向上取整。它适合短解释视频、内部口播和早期客户演示,尤其适合先获得一条可用数字人口播,再决定是否升级到 Pro。
如果你需要较低的 8 积分 / 秒档位,而且成片不必追求特别高级的质感,Kling AI Avatar Standard 会更合适。同样是人物图加音频的数字人形式,如果你更在意成片质感和品牌感,可以选择 16 积分 / 秒的 Kling AI Avatar Pro。两个档位都按经验证的音频时长计费,最长 300 秒。
如果这次只是想先确认 1 张人物图加 1 段音频能否生成可用的数字人口播,这页就够用。它很适合内部说明、简单口播和低成本数字人试稿等任务,可以先判断第一版方向,再进入更完整的制作流程。
这页就是围绕 1 张人物图、1 段音频和一个可选提示词来跑的。它没有更重的公开控制项,所以初步测试的重点不是怎么调很多参数,而是看你手上的人物图和音频,够不够支撑一条简单的 lip sync 口播视频。
先确认人物图是正脸、五官清楚、嘴部没有被挡住,音频也确实是你想保留的那条版本。这个模型本来就走轻量选项,所以素材质量往往比额外调参更重要。
这页可以先公开访问,但真正提交数字人生成前仍需要先登录。Rivya 按经验证的音频时长以 8 积分 / 秒计费,最长 300 秒且总积分向上取整;你可以先把人物图、音频和大致语气准备好,再登录执行。
如果你现在只是想验证这组人物图和音频能否生成一条可用的 Standard 口播视频,继续留在这页就够了。等项目开始需要保留版本、更换多套人物素材、反复修订,或者围绕同一位出镜人物连续产出时,再切到完整创作工作台会更顺。
比较替代模型
Seedance 2.5 是 Rivya 上规模更大的 Seedance 工作流,支持纯提示词视频、首尾帧引导、多模态参考和视频引导转换。相较 Mini,它增加了 1080p 档、最长 30 秒输出、自动时长、MP4 或 MOV 输出,并显著扩大了图片、视频与音频参考容量。
为什么考虑它
当下一个任务需要最多 50 个参考素材时,可以考虑它。
字节跳动完整版 Seedance 2.0 视频模型,当前在 Rivya 里完整接入了文生视频、首帧/首尾帧驱动,以及多模态参考生视频三类场景。产品层保留了与文档一致的角色拆分,避免把首尾帧和参考图/参考视频/参考音频混成一个模糊上传桶。
为什么考虑它
当下一个任务需要提示词、首尾帧,或图片/视频/音频参考时,可以考虑它。
字节跳动更快的 Seedance 2.0 视频模型,当前在 Rivya 里完整接入了文生视频、首帧/首尾帧驱动,以及多模态参考生视频三类场景。为了避免首尾帧和参考图/参考视频/参考音频的角色混淆,产品层保持了与文档一致的显式场景拆分。
为什么考虑它
当下一个任务需要提示词、首尾帧,或图片/视频/音频参考时,可以考虑它。
适合任务
任务接近这些情况时使用
模型参数
提供商
Kuaishou
类别
视频
能力标签
数字人口播 · 图片+音频驱动
积分模式
积分费率: 8 / 秒输入
输入方式
1 张图片 + 1 段音频
提示设置
可选