當來源畫面已具備合適的人物、構圖與動作,但嘴型需要配合另一段語音錄音時,可使用 Volcengine Video Lip Sync。
任務最終用量會向上取整為整數點數。
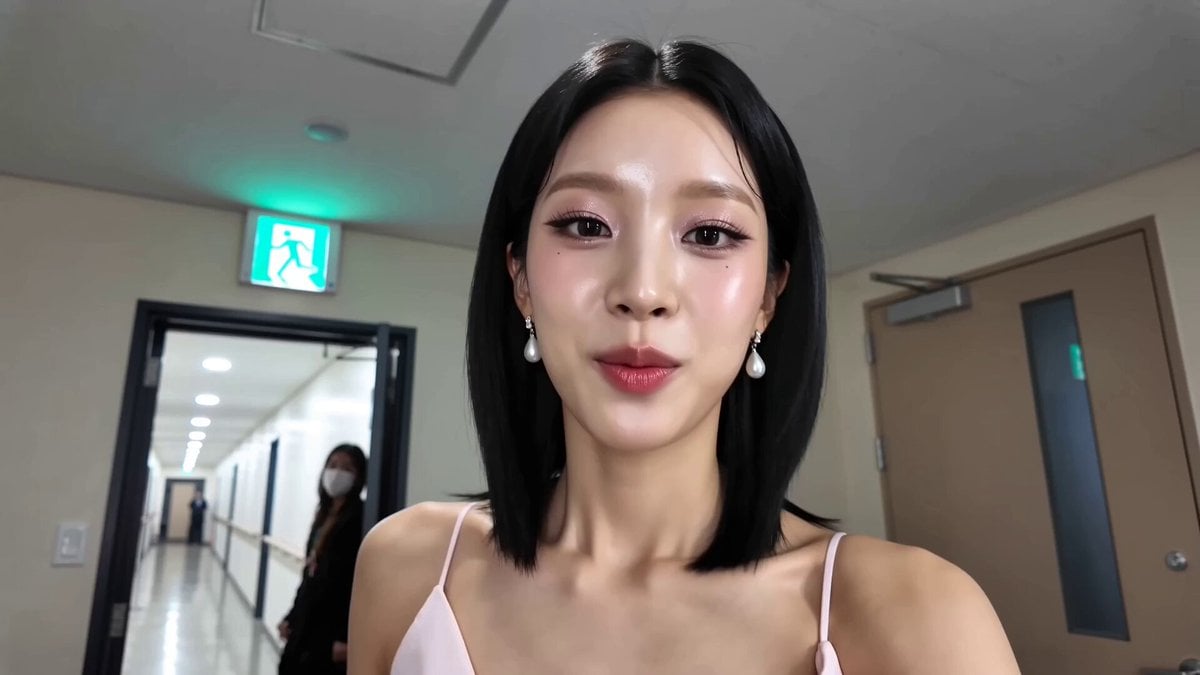
範例輸出
Volcengine Video Lip Sync
影片+音訊轉影片
範例輸出
Volcengine Video Lip Sync
最適合
支援
線上試用
目前還沒有可顯示的結果。
模型範例
瀏覽媒體與文字範例。
決策適配
決策適配
最適合的任務
任務接近這些情境時使用
模型參數
提供方
Volcengine
類別
影片
能力
影片+音訊轉影片
點數模式
點數費率: 8 / 秒輸入
輸入路徑
最多 2 個參考檔案
提示設定
不需要提示詞
Volcengine Video Lip Sync 常見問題
當來源影片已是你想保留的視覺結果,只有說話演出需要跟隨另一條人聲軌時,可使用此模型。這是影片加音訊的嘴型同步工作流程,不是提示詞引導的影片生成器或肖像動畫模型。
上傳恰好一段不超過 95 MB 的 MP4 或 MOV 影片,以及一個不超過 10 MB 的 MP3、M4A、WAV、AAC 或 OGG 音訊檔。影片幾何必須介於支援的 360p 至 1080p 範圍,影格率為每秒 24 至 60 幀、位元率為 1 至 30 Mbps,且兩個檔案都必須有大於 0 的經驗證片長。
若影片只有一人正對鏡頭,且快速處理及音訊對齊影片控制很有用,請選擇 Lite。較複雜的單人場景,尤其需要場景分段與說話者識別時,請選擇 Basic。
在 Lite 模式中,當目標音訊長於來源畫面時,音訊對齊可循環播放影片。只有開啟對齊時才可使用反向循環;模板開始值則決定來源序列的起點。Basic 模式不使用這些控制。
Rivya 依每個經驗證的音訊秒數收取 8 點積分,輸出片長會跟隨該音訊。小數片長會完整納入計算,只有預留總額會向上取整為整數積分。只有回報的實際用量有效且不高於預留額時,Rivya 才按實際用量精算並退回差額;實際用量缺失、無效或高於預留額時會進入對帳,不會觸發未揭露的額外扣款。
將一段現有的單人影片與一條目標人聲軌配對,讓畫面中的說話動作跟隨新音訊,同時保留來源畫面作為視覺基礎。
使用具有清楚可見說話者的支援 MP4 或 MOV 檔案,再準備乾淨的人聲軌。確認影片不超過 95 MB,且解析度、影格率與位元率位於列出的限制內。
簡單的正面畫面請先使用 Lite。若場景較複雜,或場景分段與說話者識別很有用,請使用 Basic。
模型詳細資訊可公開瀏覽,但上傳和生成需要登入。每個經驗證的音訊秒數為 8 點積分,結果會跟隨音訊片長,只有最終計算總額會向上取整。
若只測試一段來源影片和一條語音軌,可留在此頁面。需要儲存多次配音、重複處理語言或錄音、比較結果,或進行更長的在地化流程時,請開啟 Studio。
比較替代模型
Seedance 2.5 是 Rivya 規模較大的 Seedance 工作流程,支援純提示影片、首尾幀引導、多模態參考及影片引導轉換。相較 Mini,它新增 1080p 層級、最長 30 秒輸出、自動片長、MP4 或 MOV 輸出,以及大幅提高的圖片、影片和音訊參考容量。
為什麼考慮它
如果下一個任務需要 最多 50 個參考檔案,可以考慮它。
字節跳動完整的 Seedance 2.0 影片模型,支援純文字生成、畫面引導動畫和多模態參考生成。Rivya 清楚區分各種輸入方式,讓首幀與尾幀和多模態參考素材各自發揮明確作用。
為什麼考慮它
如果下一個任務需要 提示詞、影格,或圖片/影片/音訊參考,可以考慮它。
字節跳動更快的 Seedance 2.0 影片模型,可從純文字、首幀與尾幀,或多模態參考素材開始生成。Rivya 清楚區分各種輸入規則,避免首幀與尾幀和參考圖片、影片或音訊的用途混淆。
為什麼考慮它
如果下一個任務需要 提示詞、影格,或圖片/影片/音訊參考,可以考慮它。
開發者存取
Volcengine Video Lip Sync 已有可呼叫的 Public API 模式,但參考媒體模式仍需要 Files API 上傳支援。提交前請先查看模型參考。
