Infinitalk হলো Rivya-র audio-driven talking-video generator, যা একটি portrait image এবং একটি audio clip-কে avatar narration, podcast-to-video বা explainer-style clip-এ রূপ দেয়।
Fixed portrait-plus-audio talking-video projectcredits resolution এবং verified audio duration অনুসরণ করে480p এবং 720p output tier সমর্থন করে
ইনপুট
1টি ছবি + 1টি অডিও
ফলাফল
AI ভিডিও নির্মাতা
ক্রেডিট
per_input_second · 480p=3 · 720p=12 · ⌈total⌉
যে কাজে সেরা
talking-avatar video
উদাহরণ আউটপুট
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · Wormhole Mothership Debate-এর preview, যেখানে scene setup, camera path, motion continuity, editable details এবং final hero frame-এ জোর দেওয়া হয়েছে।
ঠোঁটের নড়াচড়ার সঙ্গে মেলানো অবতার · ছবি + অডিও চালিত
প্রথমে বর্তমান প্রাপ্যতা, ইনপুট, আউটপুট, ক্রেডিট ও প্রকাশিত উদাহরণ যাচাই করুন। অনলাইন ট্রায়াল থাকলে এই পৃষ্ঠায় মডেলটি পরীক্ষা করুন; সংরক্ষিত ইতিহাস, অ্যাসেট ও দীর্ঘ কাজের জন্য Studio ব্যবহার করুন।
উদাহরণ আউটপুট
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · Wormhole Mothership Debate-এর preview, যেখানে scene setup, camera path, motion continuity, editable details এবং final hero frame-এ জোর দেওয়া হয়েছে।
যার জন্য সেরা
talking-avatar videocharacter explainer clippodcast-to-videoavatar narration short
সমর্থন করে
ঠোঁটের নড়াচড়ার সঙ্গে মেলানো অবতারছবি + অডিও চালিত
অনলাইন পরীক্ষা
Infinitalk ব্যবহার করুন
narration, podcast বা explainer ব্যবহারের জন্য একটি portrait এবং একটি audio clip থেকে talking video তৈরি করতে Infinitalk ব্যবহার করুন।
ফলাফল
এখনও কোনো ফলাফল নেই। রান শুরু করতে একটি প্রম্পট জমা দিন।
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · Wormhole Mothership Debate-এর preview, যেখানে scene setup, camera path, motion continuity, editable details এবং final hero frame-এ জোর দেওয়া হয়েছে।
Wormhole Mothership Debate video preview, যেখানে motion rhythm, subject continuity, camera direction এবং final hero frame দেখা যাচ্ছে।
ইনপুট
1টি ছবি + 1টি অডিও
কী খেয়াল করবেন
Wormhole Mothership Debate video preview, যেখানে motion rhythm, subject continuity, camera direction এবং final hero frame দেখা যাচ্ছে।
প্রতি ব্যবহারে ক্রেডিট
per_input_second · 480p=3 · 720p=12 · ⌈total⌉
কেন এই মডেল কাজ করে
কেন এই মডেল কাজ করে
Fixed portrait-plus-audio talking-video project
credits resolution এবং verified audio duration অনুসরণ করে
480p এবং 720p output tier সমর্থন করে
সবচেয়ে উপযোগী কাজ
সবচেয়ে উপযোগী কাজ
talking-avatar videocharacter explainer clippodcast-to-videoavatar narration short
মডেলের ফলাফলের প্রমাণ
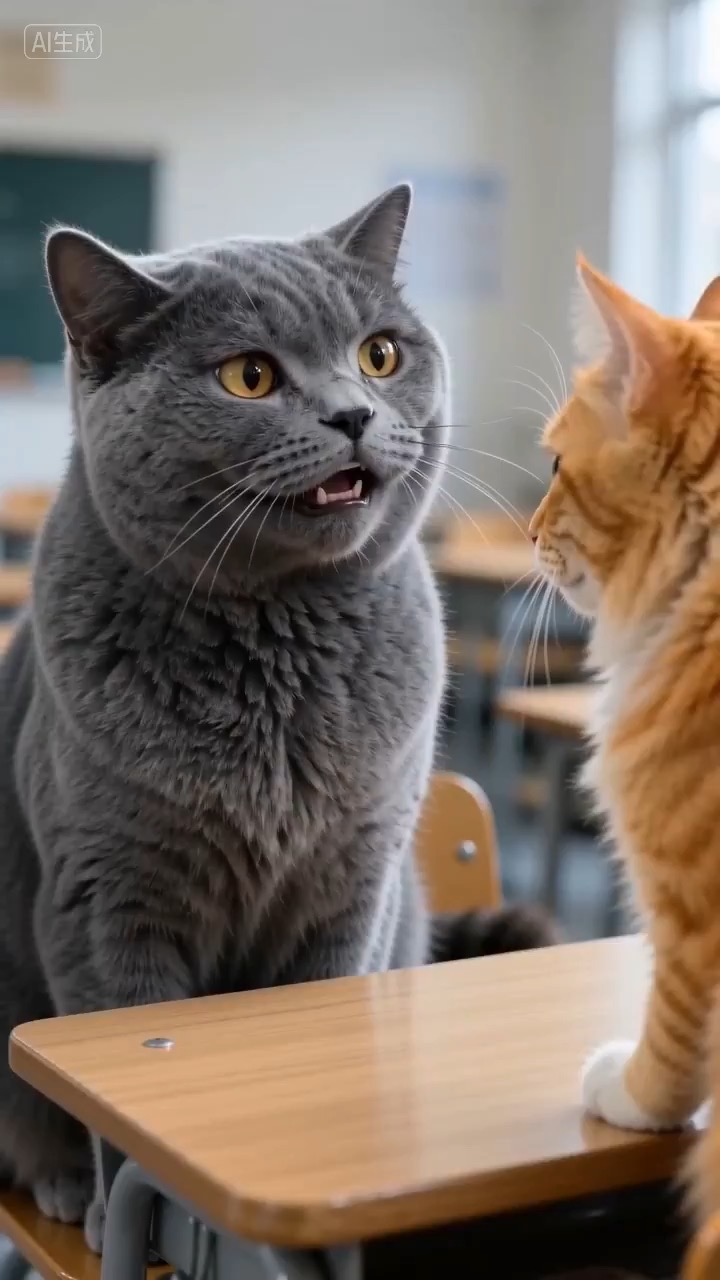
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · speaker setup, dialogue beat, reaction timing, editable details এবং final frame কেন্দ্রিক classroom reaction talking avatar preview.
natural facial motion, lip-sync timing, stable framing এবং final frame দেখানো classroom reaction talking avatar preview.
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · presenter setup, festive background, lip-sync continuity, editable greeting text এবং final hero frame-কেন্দ্রিক Lunar New Year street selfie narration brief-এর preview।
adult presenter, festive light, stable handheld framing, natural lip-sync এবং final sign-off frame দেখানো Lunar New Year street selfie narration video preview।
সিদ্ধান্তের উপযোগিতা
কখন এই মডেল সঠিক পছন্দ
সিদ্ধান্তের উপযোগিতা
উপযোগিতার সংকেত
Fixed portrait-plus-audio talking-video project
credits resolution এবং verified audio duration অনুসরণ করে
480p এবং 720p output tier সমর্থন করে
FAQ
Infinitalk FAQ
ভিডিও কাজে কখন Infinitalk ব্যবহার করব?
একটি portrait এবং একটি finished audio track আগে থেকেই কাজটি চালাচ্ছে এমন সময় Infinitalk সবচেয়ে শক্তিশালী। audio-টি timing anchor হিসেবে থাকতে হলে এবং output cost flat per-run fee-এর বদলে duration অনুযায়ী scale করা দরকার হলে talking-avatar explainer, podcast-to-video cut এবং narration-led character clip-এর জন্য এটি ভালো মানানসই।
Rivya-তে Infinitalk-এর বর্তমান বাস্তব পরিসর কী?
Rivya-তে এই option ঠিক একটি portrait image, একটি audio clip, required prompt এবং দুটি public control: resolution ও seed ঘিরে তৈরি। pricing বর্তমানে verified audio duration অনুসরণ করে, 480p-তে প্রতি সেকেন্ডে 3 credits এবং 720p-তে প্রতি সেকেন্ডে 12 credits, তাই এটি generic image-to-video model নয়, বরং duration-led talking-video project।
বাস্তব কাজে Infinitalk মূল্যায়ন করার সময় কোন control বা input সবচেয়ে গুরুত্বপূর্ণ?
সবচেয়ে গুরুত্বপূর্ণ প্রশ্ন হলো portrait-টি avatar read-এর জন্য front-facing এবং clean কি না, audio track-টি রাখার মতো final take কি না, এবং কাজটির জন্য 480p নাকি 720p যুক্তিযুক্ত। reproducibility দরকার হলেই seed সত্যিকারের গুরুত্বপূর্ণ; বেশিরভাগ সিদ্ধান্ত source portrait, source audio এবং resolution-cost tradeoff-এ থাকে।
Rivya-তে বর্তমান credit tier-এ Infinitalk কখন সার্থক?
Rivya বর্তমানে 480p-তে প্রতি সেকেন্ডে 3 credits এবং 720p-তে প্রতি সেকেন্ডে 12 credits দেখায়। finished voice track আগে থেকেই থাকলে এবং প্রতিটি run-এর জন্য flat avatar fee দেওয়ার বদলে actual spoken duration অনুযায়ী video cost scale করতে চাইলে এটি সহজে যুক্তিযুক্ত হয়।
Rivya-তে হালকা বা সস্তা বিকল্পের বদলে কখন Infinitalk বেছে নেব?
প্রতি সেকেন্ডে 8 credits-এর lower rate যথেষ্ট হলে এবং output বিশেষ premium দেখানোর দরকার না হলে Kling AI Avatar Standard বেছে নিন। একই portrait-plus-audio format-এ higher-finish result-এর জন্য প্রতি সেকেন্ডে 16 credits-এর Kling AI Avatar Pro বেছে নিন। দুটো tier-ই verified audio duration অনুযায়ী, সর্বোচ্চ 300 সেকেন্ড পর্যন্ত charge হয়। Rivya-তে এই option ঠিক একটি portrait image, একটি audio clip, required prompt এবং দুটি public control: resolution ও seed ঘিরে তৈরি। pricing বর্তমানে verified audio duration অনুসরণ করে, 480p-তে প্রতি সেকেন্ডে 3 credits এবং 720p-তে প্রতি সেকেন্ডে 12 credits, তাই এটি generic image-to-video model নয়, বরং duration-led talking-video project।
এই পেজে প্রথমে কী পরীক্ষা করতে পারি?
একটি portrait এবং একটি audio file বিশ্বাসযোগ্য talking-video pass বহন করতে পারবে কি না, প্রথম result-এ সেটাই যাচাই দরকার হলে এখান থেকে শুরু করুন। audio আগে থেকেই হাতে থাকলে explainer, podcast-to-video test এবং narration-led avatar clip-এর জন্য এটি ব্যবহার করুন।
এই পেজে কী সেটআপ করা যায়?
এই page একটি portrait image, একটি audio clip, required prompt, resolution ও seed ব্যবহার করে। এটি general-purpose animation tool নয়; প্রথম run-এ portrait ও audio pair থেকে ব্যবহারযোগ্য talking result হয় কি না test করুন।
Run করার আগে কোন control দেখা দরকার?
Run করার আগে portrait face-forward এবং clean কি না, audio রাখার মতো take কি না, এবং resolution choice budget-এর সঙ্গে মেলে কি না নিশ্চিত করুন। talking-video behavior শুধু validate করলে 480p দিয়ে শুরু করুন, আর clearer presenter output বেশি per-second spend-এর যোগ্য হলে 720p-তে যান।
এখানে run করার আগে কি সাইন ইন দরকার, আর credits কীভাবে কাজ করে?
পেজটি public, কিন্তু প্রকৃত প্রথম image-led video run করতে এখনও sign in দরকার। Rivya বর্তমানে 480p-তে প্রতি সেকেন্ডে 3 credits এবং 720p-তে প্রতি সেকেন্ডে 12 credits দেখায়, তাই portrait, audio এবং duration expectation আগে সাজিয়ে নিয়ে generate করতে প্রস্তুত হলে sign in করুন।
কখন এই পেজেই থাকব, আর কখন পূর্ণ Studio-তে যাব?
একটি portrait-audio pair পরীক্ষা করার সময় এবং প্রথম talk pass যথেষ্ট কি না দেখার সময় এই পেজেই থাকুন। saved version, multiple avatar asset বা একই character ঘিরে দীর্ঘ production thread দরকার হলে পূর্ণ Studio খুলুন।
বিকল্প তুলনা করুন
এরপর বিবেচনার মতো অন্য মডেল
ভিডিও
Seedance 2.5
Seedance 2.5 হলো Rivya-র বৃহত্তর Seedance কর্মপ্রবাহ, যা শুধু প্রম্পটের ভিডিও, প্রথম ও শেষ ফ্রেম নির্দেশনা, মাল্টিমোডাল রেফারেন্স এবং ভিডিও-নির্দেশিত রূপান্তর সমর্থন করে। Mini-র তুলনায় এতে 1080p স্তর, 30 সেকেন্ড পর্যন্ত আউটপুট, স্বয়ংক্রিয় মেয়াদ, MP4 বা MOV আউটপুট এবং অনেক বেশি ছবি, ভিডিও ও অডিও রেফারেন্স ধারণক্ষমতা রয়েছে।
কেন বিবেচনা করবেন
আপনার পরের কাজে সর্বোচ্চ 50টি রেফারেন্স ফাইল দরকার হলে এটি বিবেচনা করুন।
ByteDance-এর full Seedance 2.0 video model, prompt-only generation, frame-driven animation এবং multimodal reference generation-এর explicit support সহ। Rivya documented role split explicit রাখে, যাতে frame input এবং multimodal reference এক অস্পষ্ট upload bucket-এ collapse না করে mutually exclusive থাকে।
কেন বিবেচনা করবেন
আপনার পরের কাজে প্রম্পট, ফ্রেম অথবা ছবি/ভিডিও/অডিও রেফারেন্স দরকার হলে এটি বিবেচনা করুন।
যে কাজে সেরাprompt, frame বা reference bundle থেকে higher-quality short video
ভিডিও
Seedance 2.0 Fast
ByteDance-এর faster Seedance 2.0 video model, prompt-only generation, frame-driven image animation এবং multimodal reference video generation-এর জন্য full scene routing সহ। Rivya documented scene split explicit রাখে, যাতে first/last-frame input reference image, video এবং audio role-এর সঙ্গে collide না করে।
কেন বিবেচনা করবেন
আপনার পরের কাজে প্রম্পট, ফ্রেম অথবা ছবি/ভিডিও/অডিও রেফারেন্স দরকার হলে এটি বিবেচনা করুন।
উদাহরণ; তৈরির মডেল যাচাই করা হয়নি · Scene setup, camera path, motion continuity, editable details, এবং final hero frame-এ ফোকাস করা Traveler Street Reaction Short preview।
Motion rhythm, subject continuity, camera direction, এবং final hero frame দেখানো Traveler Street Reaction Short video preview।
podcast, explainer এবং avatar narration-এর জন্য ভালো
duration-based talking-video run-এর জন্য ভালো কাজ করে
সবচেয়ে উপযোগী কাজ
কাজটি এমন হলে ব্যবহার করুন
talking-avatar videocharacter explainer clippodcast-to-videoavatar narration shortaudio-driven video sample
মূল তথ্য
ইনপুট, ফলাফল ও ক্রেডিট নিশ্চিত করুন
সেবাদাতা
MeiGen-AI
বিভাগ
ভিডিও
সক্ষমতা
ঠোঁটের নড়াচড়ার সঙ্গে মেলানো অবতার · ছবি + অডিও চালিত