
Handheld day-in-the-life vlog
An illustrative scene for the example gallery.
画像1枚と4~300秒の音声から、音声に合わせた動画を作成します。プロンプトは任意で、最大300文字です。
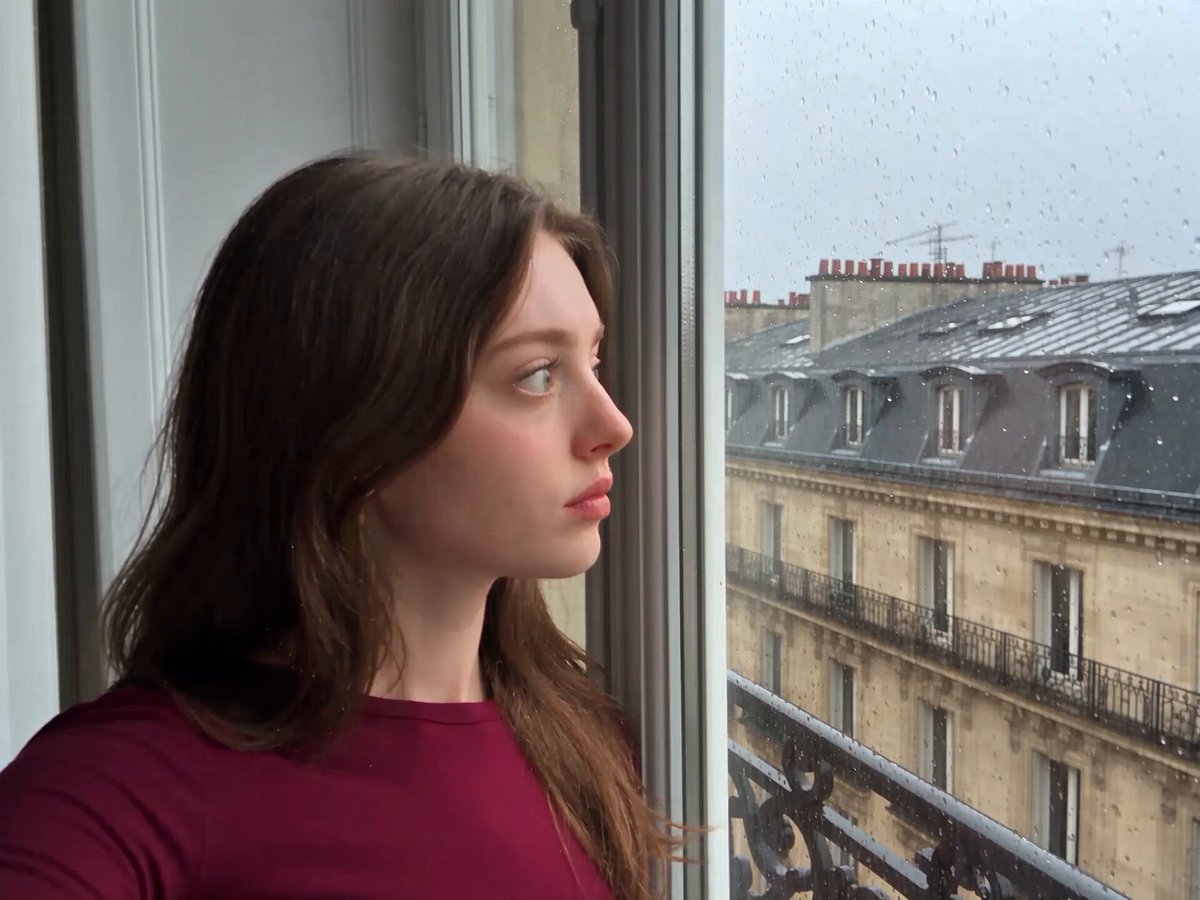
出力例
An illustrative scene for the example gallery.
最適
対応
オンライン試用
表示できる結果はまだありません。
モデルの作例
メディアとテキストの作例をご覧ください。
An illustrative scene for the example gallery.
An illustrative scene for the example gallery.
判断材料
判断材料
最適なタスク
タスクがこのような場合に使えます
モデルの詳細
OmniHuman 2.0 FAQ
画像1枚と4~300秒の音声から、音声に合わせた動画を作成します。プロンプトは任意で、最大300文字です。
送信前にクレジットを確保します。確認された使用量に基づいて精算し、未使用分を返却します。送信結果や使用量を確認できない場合は、照合が完了するまで確保したままになります。再送前にクレジット履歴を確認してください。
代替モデルを比較
Seedance 2.5 は、テキストのみの動画、開始・終了フレームによるガイド、マルチモーダル参照、動画をガイドにした変換に対応する、Rivya の大規模な Seedance ワークフローです。Mini よりも大きな画像・動画・音声の参照容量に加え、1080p、最大 30 秒の出力、自動時間設定、MP4 または MOV 出力に対応しています。
検討する理由
次のタスクに 最大 50 件の参照ファイル が必要な場合に検討できます。
ByteDance のフル機能版 Seedance 2.0 動画モデルです。プロンプトのみの生成、フレームを使うアニメーション、画像・動画・音声によるマルチモーダル参照生成に対応しています。開始・終了フレームと各参照素材は、用途に応じて別々に指定できます。
検討する理由
次のタスクに プロンプト、フレーム、または画像/動画/音声参照 が必要な場合に検討できます。
タスクの最終費用は整数クレジットに切り上げられます。
出力例
An illustrative scene for the example gallery.
画像+音声から動画
An illustrative scene for the example gallery.
An illustrative scene for the example gallery.
An illustrative scene for the example gallery.
An illustrative scene for the example gallery.
プロバイダー
ByteDance
カテゴリ
動画
機能
画像+音声から動画
クレジットモデル
クレジット単価: 14 / 入力1秒
入力経路
画像 1 枚 + 音声 1 件
プロンプト設定
任意
開発者アクセス
OmniHuman 2.0 には呼び出し可能な Public API モードがありますが、参照メディアモードにはまだ Files API アップロードサポートが必要です。送信前にモデルリファレンスを確認してください。
ByteDance の高速な Seedance 2.0 動画モデルです。プロンプトのみの生成、開始・終了フレームを使う画像アニメーション、画像・動画・音声によるマルチモーダル参照生成に対応しています。
検討する理由
次のタスクに プロンプト、フレーム、または画像/動画/音声参照 が必要な場合に検討できます。