8-10s
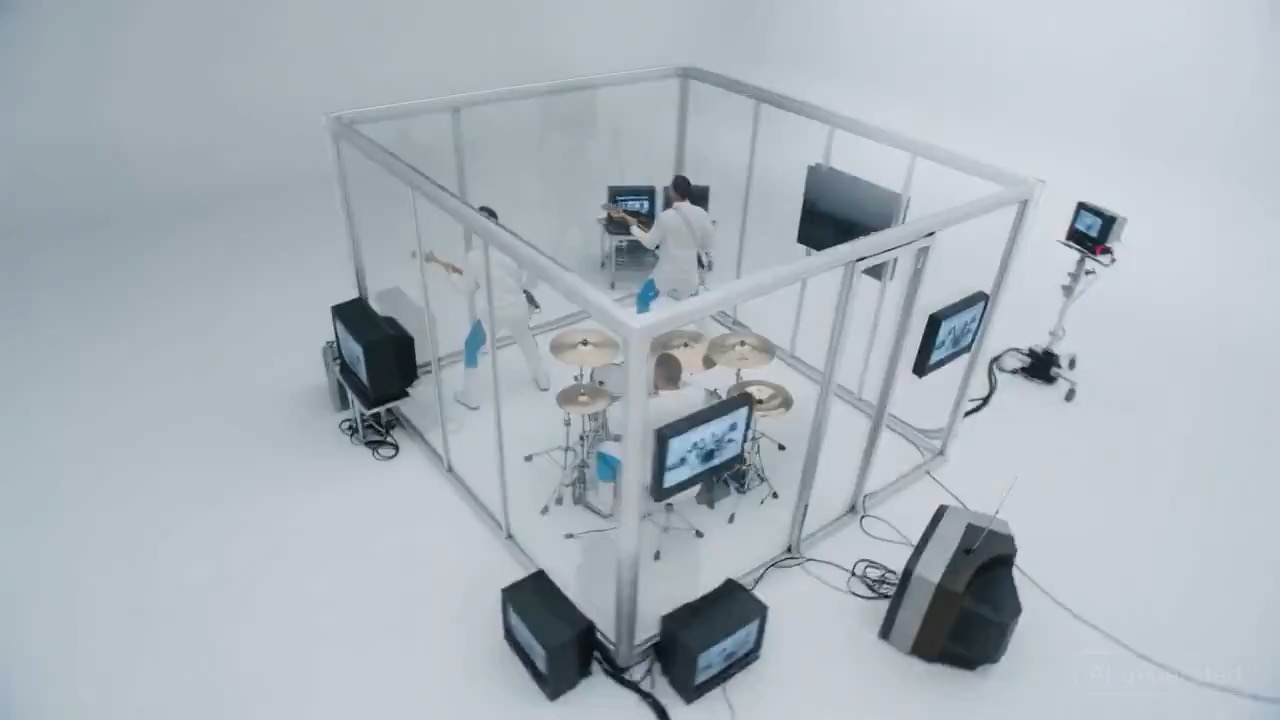
معاينة فيديو لأداء على مسرح مكعب شفاف تعرض إيقاع الضوء، واستمرارية المؤدي، وتوجيه الكاميرا، وإطار البطل النهائي.
موجز فيديو مسرح مكعب شفاف: الإعداد / كشف الأداء / مسار الكاميرا / استمرارية الإضاءة / نهاية البطل / فحوص المراجعة
Kling AI Avatar Pro هو نموذج avatar ناطق عالي الدقة في Rivya لتحويل صورة بورتريه واحدة ومقطع صوتي واحد إلى فيديو مقدم أكثر صقلا.
مخرج مثال
مثال؛ لم يتم التحقق من النموذج الذي أنشأه · معاينة لأداء على مسرح مكعب شفاف، تركز على إعداد المشهد، ومسار الكاميرا، واستمرارية الإضاءة، والتفاصيل القابلة للتحرير، وإطار البطل النهائي.
أفاتار متزامن الشفاه · مدعوم بالصورة والصوت
مخرج مثال
مثال؛ لم يتم التحقق من النموذج الذي أنشأه · معاينة لأداء على مسرح مكعب شفاف، تركز على إعداد المشهد، ومسار الكاميرا، واستمرارية الإضاءة، والتفاصيل القابلة للتحرير، وإطار البطل النهائي.
أفضل لـ
يدعم
تجربة عبر الإنترنت
لا توجد نتيجة بعد. أرسل موجّهًا لبدء عملية إنشاء.
بدايات الموجّهات
إثبات النموذج
استخدم التجربة عبر الإنترنت أعلاه، ثم قارن نتائج الأمثلة هذه لتقييم جودة النتيجة والإيقاع وملاءمة المهمة قبل إنفاق المزيد من الأرصدة في Studio.
العينة الرئيسية
معاينة فيديو لأداء على مسرح مكعب شفاف تعرض إيقاع الضوء، واستمرارية المؤدي، وتوجيه الكاميرا، وإطار البطل النهائي.
المدخل
صورة واحدة + صوت واحد
ما ينبغي ملاحظته
معاينة فيديو لأداء على مسرح مكعب شفاف تعرض إيقاع الضوء، واستمرارية المؤدي، وتوجيه الكاميرا، وإطار البطل النهائي.
الأرصدة لكل استخدام
per_input_second · default=16 · ⌈total⌉
لماذا يعمل هذا النموذج
مشروع avatar ناطق عالي الجودة ثابت يجمع بورتريه وصوتا
16 رصيدا لكل ثانية من الصوت المتحقق منه، مع تقريب الإجمالي لأعلى
أنسب لمخرجات lip-sync تعطي الجودة الأولوية
أفضل المهام المناسبة
إثبات النموذج
ملاءمة القرار
ملاءمة القرار
الأسئلة الشائعة حول Kling AI Avatar Pro
يكون Kling AI Avatar Pro في أقوى حالاته عندما تحتاج المهمة إلى avatar ناطق أنظف وأكثر صقلا بأسلوب مقدم من بورتريه واحد ومقطع صوتي واحد. يناسب فيديوهات المقدم ذات العلامة، والشروحات premium، ومقاطع avatar القصيرة الأكثر صقلا عندما تبرر الجودة الإضافية معدل 16 رصيدا في الثانية.
على Rivya، يبنى هذا الخيار حول صورة بورتريه واحدة، ومقطع صوتي يصل إلى 300 ثانية، وprompt اختياري. يكلف 16 رصيدا لكل ثانية من الصوت المتحقق منه، ويقرب الإجمالي لأعلى رصيد كامل.
القرار الأكبر عادة هو هل صورة المصدر وصوت المصدر مصقولان بما يكفي ليستحقا طبقة Pro. لأن إعداد الصفحة العام هنا بسيط عمدا، تأتي معظم جودة النتيجة من الصورة الأمامية النظيفة، ووضوح الصوت، وما إذا كانت اللمسة المصقولة الإضافية تستحق الدفع مقارنة بطبقة Standard الأرخص.
تخصم Rivya 16 رصيدا لكل ثانية من الصوت المتحقق منه، حتى 300 ثانية، وتقرب الإجمالي إلى أعلى رصيد كامل. يناسب معدل Pro الحالات التي يكون فيها مقطع مقدم أو شرح عالي الجودة أهم من أدنى تكلفة ممكنة.
اختر Kling AI Avatar Standard عندما يكفي المعدل الأقل، 8 أرصدة في الثانية. اختر Kling AI Avatar Pro عندما تريد مشروع بورتريه وصوتا بسيطا، لكن النتيجة تحتاج إلى مظهر أكثر premium بمعدل 16 رصيدا في الثانية. يحاسب المستويان حسب مدة الصوت المتحقق منه حتى 300 ثانية.
ابدأ هنا عندما تحتاج النتيجة الأولى إلى إخبارك هل يستطيع بورتريه واحد ومقطع صوتي واحد إنتاج فيديو avatar مصقول بأسلوب مقدم بالفعل. استخدمه لمقاطع الشرح premium والتسليم القصير الذي يحمل العلامة عندما تكون الجودة أهم من جعل تمريرة avatar الأولى رخيصة قدر الإمكان.
هذه الصفحة خيار avatar يجمع البورتريه والصوت مع prompt اختياري. تكلف 16 رصيدا لكل ثانية من الصوت المتحقق منه حتى 300 ثانية، وتتعلق النتيجة الأولى أساسا بالتحقق من صورة أمامية واحدة ومسار الصوت النهائي.
قبل التشغيل، تأكد من أن البورتريه نظيف وأمامي، وأن الصوت هو النسخة التي تريد فعلا الاحتفاظ بها، وأن prompt الاختياري يضيف فقط نبرة خفيفة أو إرشادا للمشهد. في هذا النموذج، جودة المصدر تفعل أكثر من ضبط المعلمات لأن إعداد التحكم العام بسيط عمدا.
الصفحة عامة، لكن تشغيل الفيديو الأول القائم على صورة يتطلب تسجيل الدخول. تخصم Rivya 16 رصيدا لكل ثانية من الصوت المتحقق منه، بحد أقصى 300 ثانية، وتقرب الإجمالي لأعلى؛ ويمكنك إعداد البورتريه والصوت واتجاه النبرة قبل تسجيل الدخول.
ابق في هذه الصفحة أثناء فحص زوج بورتريه وصوت واحد والتحقق مما إذا كانت تمريرة Pro تستحق الاحتفاظ بها. افتح Studio الكامل عندما يحتاج العمل إلى نسخ محفوظة، أو أصول avatar متعددة، أو سلسلة إنتاج أطول حول المقدم أو الشخصية نفسها.
قارن البدائل
Seedance 2.5 هو سير عمل Seedance الأكبر في Rivya للفيديو من الموجّه وحده، وإرشاد الإطارين الأول والأخير، والمراجع متعددة الوسائط، والتحويل الموجّه بالفيديو. يضيف فئة 1080p، وإخراجا يصل إلى 30 ثانية، ومدة تلقائية، وإخراج MP4 أو MOV، وسعة أكبر بكثير لمراجع الصور والفيديو والصوت مقارنة بـ Mini.
لماذا تفكر فيه
فكّر فيه عندما تحتاج مهمتك التالية إلى ما يصل إلى 50 ملفات مرجعية.
نموذج فيديو Seedance 2.0 الكامل من ByteDance مع دعم واضح للتوليد من الوصف فقط، والتحريك الموجه بالإطارات، والتوليد من مراجع متعددة الوسائط. تبقي Rivya تقسيم الأدوار الموثق واضحا حتى تبقى مدخلات الإطارات والمراجع المتعددة الوسائط منفصلة، بدلا من دمجها في خانة رفع واحدة غامضة.
لماذا تفكر فيه
فكّر فيه عندما تحتاج مهمتك التالية إلى موجّه أو إطارات أو مراجع صورة/فيديو/صوت.
نموذج فيديو Seedance 2.0 الأسرع من ByteDance، مع توجيه كامل للمشاهد عبر توليد يعتمد على الوصف فقط، وتحريك الصور الموجه بالإطارات، وتوليد الفيديو من مراجع متعددة الوسائط. تبقي Rivya تقسيم المشاهد الموثق واضحا حتى لا تتداخل مدخلات الإطار الأول أو الأخير مع أدوار الصورة والفيديو والصوت المرجعية.
لماذا تفكر فيه
فكّر فيه عندما تحتاج مهمتك التالية إلى موجّه أو إطارات أو مراجع صورة/فيديو/صوت.
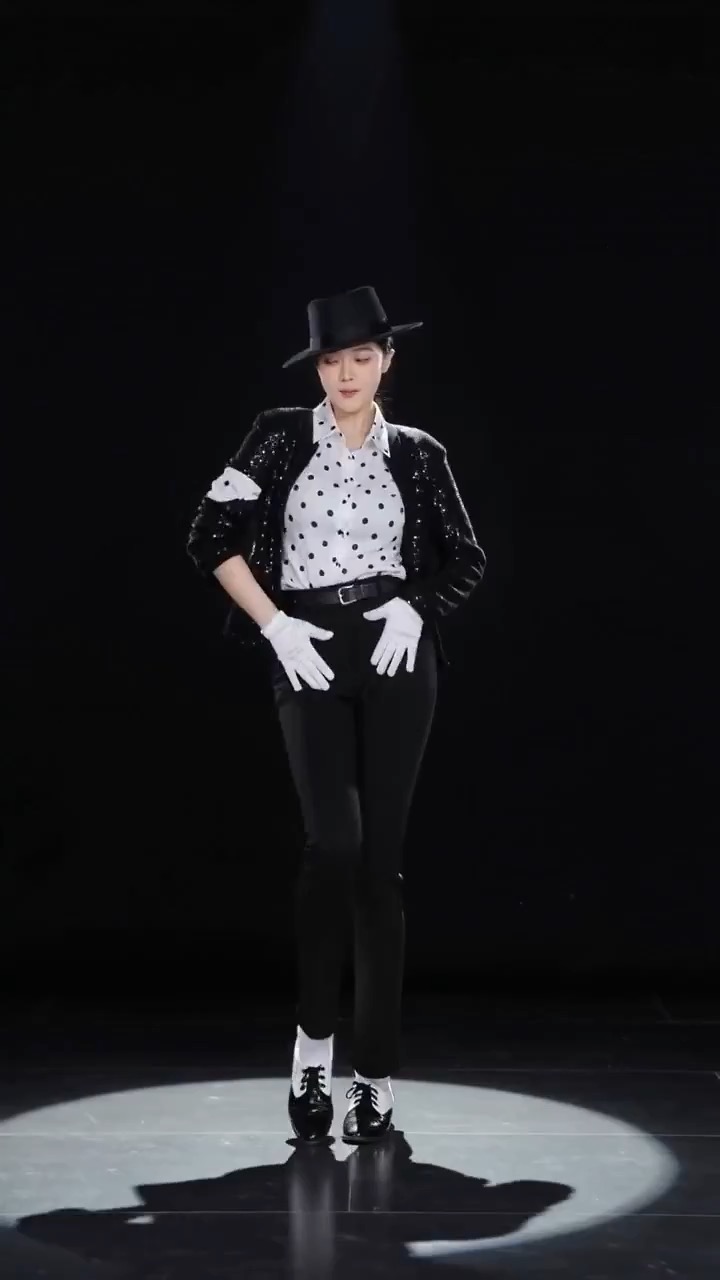
معاينة رقصة أفاتار أحادية اللون تحت ضوء كاشف، يظهر فيها راقص واحد يتحرك داخل مخروط ضوء حاد.
أفضل المهام المناسبة
استخدمه عندما تبدو المهمة هكذا
حقائق عملية
المزود
Kuaishou
الفئة
فيديو
القدرات
أفاتار متزامن الشفاه · مدعوم بالصورة والصوت
نموذج الأرصدة
per_input_second · default=16 · ⌈total⌉
مسار المدخل
صورة واحدة + صوت واحد
إعداد الموجّه
اختياري