Wan 2.2 A14B Turbo menyokong tiga laluan permulaan di Rivya: teks, satu imej atau satu imej bersama klip audio untuk video berpandukan audio. Gunakannya untuk eksperimen Wan yang lebih ringan, klip pendek berpandukan imej dan gerakan potret yang dibimbing oleh audio yang diberikan.
Satu model merangkumi penjanaan video daripada teks, imej dan imej bersama audioPeringkat kredit membezakan penjanaan teks atau imej yang lebih ringan daripada penjanaan berpandukan audio yang lebih berat
Laluan berpandukan imej-tambah-audio mengekalkan set kecil parameter lanjutan tersendiri dan tidak meruntuhkan semuanya kepada lalai
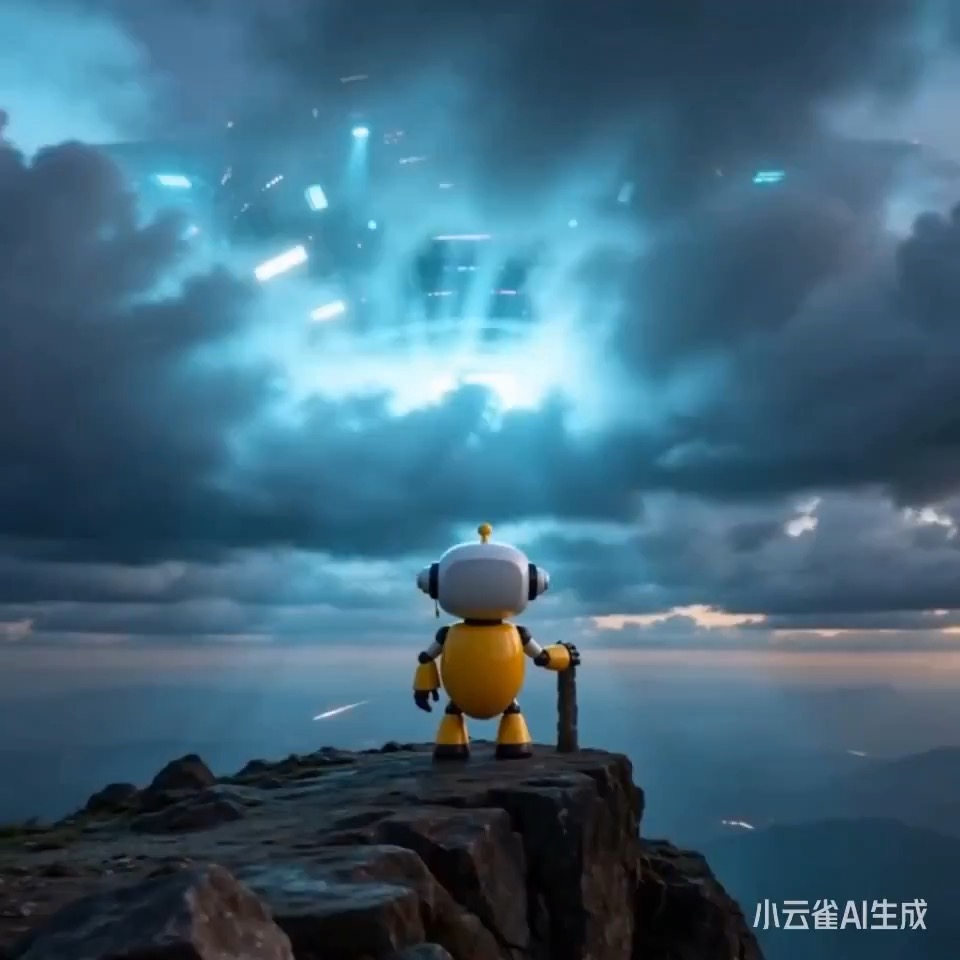
Contoh; model penjanaan belum disahkan · Pratonton untuk brief video robot sunyi di puncak, berfokus pada penetapan luas, laluan kamera perlahan, kesinambungan atmosfera, butiran boleh diedit, dan frame hero akhir.
Semak ketersediaan semasa, input, output, kredit dan contoh terlebih dahulu. Jika percubaan dalam talian tersedia, uji model pada halaman ini; gunakan Studio untuk sejarah tersimpan, aset dan proses berulang yang lebih panjang.
Contoh output
Contoh; model penjanaan belum disahkan · Pratonton untuk brief video robot sunyi di puncak, berfokus pada penetapan luas, laluan kamera perlahan, kesinambungan atmosfera, butiran boleh diedit, dan frame hero akhir.
Terbaik untuk
Eksperimen Wan teks-ke-video yang lebih ringanMenjana klip pendek daripada satu imejKlip potret bercakap atau separa bercakap daripada satu imej pegun bersama satu fail audioPasukan yang mahukan peringkat video Wan lebih lama di bawah Wan 2.6
Menyokong
Teks ke VideoImej ke VideoDipacu Imej + Audio
Percubaan dalam talian
Cuba Wan 2.2 A14B Turbo
Cuba Wan 2.2 A14B Turbo apabila anda mahukan pilihan Wan yang lebih ringan tetapi masih boleh meliputi teks-ke-video, imej-ke-video, dan video imej-tambah-audio dalam satu keluarga model. Mulakan daripada teks, tambah satu imej untuk imej-ke-video, atau padankan satu imej dengan satu klip audio untuk laluan berpandukan pertuturan.
Hasil
Belum ada hasil. Hantar prompt untuk memulakan sesi.
Gunakan percubaan dalam talian di atas, kemudian bandingkan contoh hasil ini untuk menilai kemasan, ritma dan kesesuaian tugasan sebelum membelanjakan lebih banyak kredit dalam Studio.
Contoh; model penjanaan belum disahkan · Pratonton untuk brief video robot sunyi di puncak, berfokus pada penetapan luas, laluan kamera perlahan, kesinambungan atmosfera, butiran boleh diedit, dan frame hero akhir.
Pratonton video robot sunyi di puncak yang menunjukkan puncak gunung luas, hanyutan kamera terkawal, kesinambungan subjek, skala atmosfera, dan frame hero akhir.
Input
Prompt, 1 imej atau 1 imej + 1 audio
Perkara yang perlu diperhatikan
Pratonton video robot sunyi di puncak yang menunjukkan puncak gunung luas, hanyutan kamera terkawal, kesinambungan subjek, skala atmosfera, dan frame hero akhir.
Satu model merangkumi penjanaan video daripada teks, imej dan imej bersama audio
Peringkat kredit membezakan penjanaan teks atau imej yang lebih ringan daripada penjanaan berpandukan audio yang lebih berat
Laluan berpandukan imej-tambah-audio mengekalkan set kecil parameter lanjutan tersendiri dan tidak meruntuhkan semuanya kepada lalai
Tugasan paling sesuai
Tugasan paling sesuai
Eksperimen Wan teks-ke-video yang lebih ringanMenjana klip pendek daripada satu imejKlip potret bercakap atau separa bercakap daripada satu imej pegun bersama satu fail audioPasukan yang mahukan peringkat video Wan lebih lama di bawah Wan 2.6
Bukti model
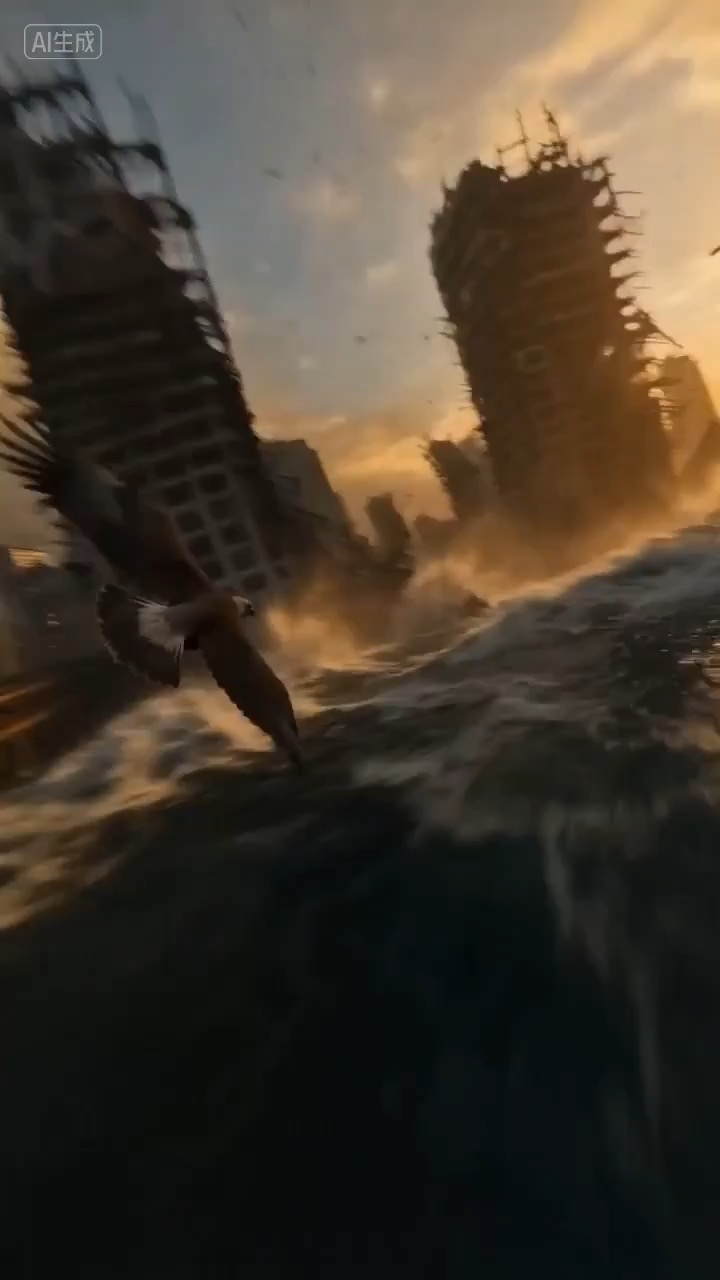
Contoh; model penjanaan belum disahkan · Penerbangan helang orang pertama melepasi halangan latar depan yang pecah, mengekalkan laluan keluar, dan terbuka kepada pemandangan luas penuh cahaya.
Pratonton video penerbangan melarikan diri POV helang dengan luncuran pantas yang boleh dibaca melalui batu runtuhan menuju cahaya terbuka.
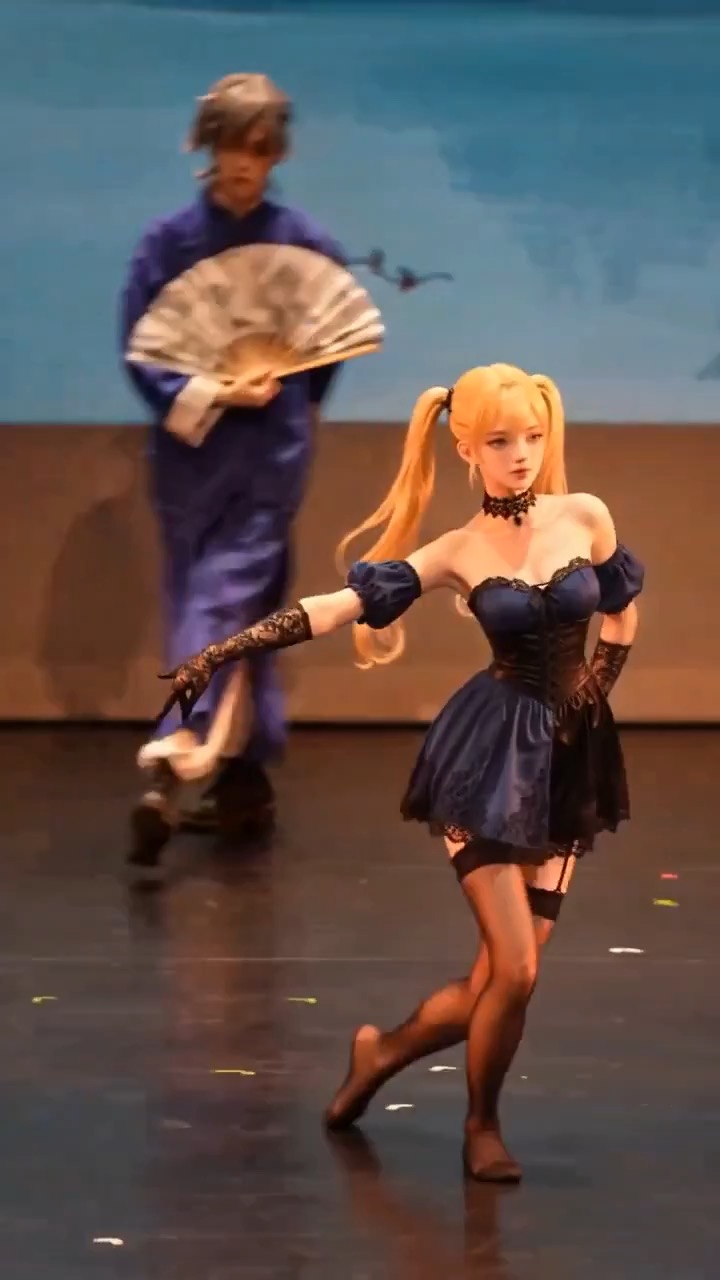
Contoh; model penjanaan belum disahkan · Klip pratonton untuk prompt aksi watak rujukan, memfokuskan rentak adegan, ritma kamera, kesinambungan, dan detik hero akhir.
Pratonton video aksi watak rujukan yang menunjukkan gaya gerakan, arah kamera, dan ritma output untuk prompt ini.
Kesesuaian keputusan
Bila model ini pilihan yang tepat
Kesesuaian keputusan
Isyarat kesesuaian
Satu model merangkumi penjanaan video daripada teks, imej dan imej bersama audio
Peringkat kredit membezakan penjanaan teks atau imej yang lebih ringan daripada penjanaan berpandukan audio yang lebih berat
FAQ
FAQ Wan 2.2 A14B Turbo
Bilakah saya patut menggunakan Wan 2.2 A14B Turbo untuk kerja video?
Gunakan Wan 2.2 A14B Turbo untuk ujian teks-ke-video yang lebih ringan, klip pendek daripada satu imej atau gerakan potret berpandukan satu imej pegun bersama satu fail audio. Model ini berguna apabila anda mahu ketiga-tiga laluan permulaan dalam satu model dengan peringkat kredit berasingan untuk penjanaan ringan dan berpandukan audio.
Apakah skop sebenar Wan 2.2 A14B Turbo di Rivya sekarang?
Di Rivya, Wan 2.2 A14B Turbo pada masa ini menyokong teks-ke-video, imej-ke-video, dan laluan berpandukan imej + audio. Ia juga boleh menerima sehingga 2 fail rujukan merentas input imej dan input audio.
Kawalan atau input manakah yang paling penting setelah anda menilai Wan 2.2 A14B Turbo untuk kerja sebenar?
Input teks dan imej menyokong 480p atau 720p (40 atau 80 kredit untuk 5 saat). Imej dengan audio turut menyokong 580p; kadar 480p / 580p / 720p ialah 12 / 18 / 24 kredit setiap saat output.
Bilakah Wan 2.2 A14B Turbo berbaloi dengan peringkat kredit semasa di Rivya?
Input teks dan imej menyokong 480p atau 720p (40 atau 80 kredit untuk 5 saat). Imej dengan audio turut menyokong 580p; kadar 480p / 580p / 720p ialah 12 / 18 / 24 kredit setiap saat output.
Bilakah saya patut memilih Wan 2.2 A14B Turbo berbanding alternatif yang lebih ringan atau murah di Rivya?
Pilih Wan 2.2 A14B Turbo apabila anda memerlukan penjanaan video daripada teks, imej dan imej bersama audio dalam satu model. Jika anda hanya memerlukan ujian teks atau imej asas, bandingkan pilihan lebih khusus yang berkos rendah terlebih dahulu.
Apakah yang boleh saya uji dahulu di halaman ini?
Mulakan di sini apabila percubaan pertama ditujukan kepada eksperimen Wan teks-ke-video yang lebih ringan, penjanaan klip pendek daripada satu imej, dan klip potret bercakap atau separa bercakap daripada satu imej pegun bersama satu fail audio. Ini memastikan percubaan pertama kekal praktikal: semak input, arah, dan kualiti hasil di sini sebelum menukarnya menjadi projek yang lebih panjang.
Apakah yang boleh saya sediakan di halaman ini?
Halaman ini pada masa ini menyokong teks-ke-video, imej-ke-video, dan laluan berpandukan imej + audio. Ini memudahkan anda melihat sama ada penerangan syot tulen atau permulaan berpandukan imej ialah jalan masuk yang lebih baik ke eksperimen Wan teks-ke-video yang lebih ringan. Anda juga boleh membawa masuk sehingga 2 fail rujukan merentas input imej dan input audio.
Kawalan manakah yang patut disemak sebelum saya menekan butang jalankan?
Input teks dan imej menyokong 480p atau 720p (40 atau 80 kredit untuk 5 saat). Imej dengan audio turut menyokong 580p; kadar 480p / 580p / 720p ialah 12 / 18 / 24 kredit setiap saat output.
Adakah saya perlu log masuk sebelum menjalankan di sini, dan bagaimanakah kredit berfungsi?
Input teks dan imej menyokong 480p atau 720p (40 atau 80 kredit untuk 5 saat). Imej dengan audio turut menyokong 580p; kadar 480p / 580p / 720p ialah 12 / 18 / 24 kredit setiap saat output.
Bilakah saya patut kekal di halaman ini, dan bilakah saya patut beralih ke Studio penuh?
Kekal di halaman ini semasa anda masih mengesahkan syot pertama, jenis sumber, dan sama ada hasil pertama membawa anda hampir kepada eksperimen Wan teks-ke-video yang lebih ringan pada Wan 2.2 A14B Turbo. Buka Studio penuh apabila kerja memerlukan versi tersimpan, iterasi klip berulang, berbilang aset, atau rangkaian produksi yang lebih panjang sekitar set adegan yang sama.
Bandingkan alternatif
Model lain untuk dipertimbangkan seterusnya
Video
Seedance 2.5
Seedance 2.5 ialah aliran kerja Seedance Rivya yang lebih besar untuk video berasaskan prompt sahaja, panduan bingkai pertama dan terakhir, rujukan multimodal serta transformasi berpandukan video. Ia menambah peringkat 1080p, output sehingga 30 saat, tempoh automatik, output MP4 atau MOV dan kapasiti rujukan imej, video serta audio yang jauh lebih besar berbanding Mini.
Sebab mempertimbangkannya
Pertimbangkannya apabila tugasan seterusnya memerlukan Sehingga 50 fail rujukan.
Model video Seedance 2.0 penuh ByteDance dengan sokongan eksplisit untuk penjanaan prompt sahaja, animasi berpandukan bingkai dan penjanaan rujukan multimodal. Rivya mengekalkan pemisahan peranan terdokumen secara eksplisit supaya input bingkai dan rujukan multimodal kekal saling eksklusif, bukan runtuh menjadi satu ruang muat naik yang kabur.
Sebab mempertimbangkannya
Pertimbangkannya apabila tugasan seterusnya memerlukan Prompt, bingkai atau rujukan imej/video/audio.
InputPrompt, bingkai atau rujukan imej/video/audio
Terbaik untukVideo pendek berkualiti lebih tinggi daripada prompt, bingkai atau himpunan rujukan
Video
Seedance 2.0 Fast
Model video Seedance 2.0 ByteDance yang lebih pantas dengan penghalaan adegan penuh untuk penjanaan prompt sahaja, animasi imej berpandukan bingkai dan penjanaan video rujukan multimodal. Rivya mengekalkan pemisahan adegan terdokumen secara eksplisit supaya input bingkai pertama/terakhir tidak bercampur dengan peranan imej rujukan, video dan audio.
Sebab mempertimbangkannya
Pertimbangkannya apabila tugasan seterusnya memerlukan Prompt, bingkai atau rujukan imej/video/audio.
InputPrompt, bingkai atau rujukan imej/video/audio
Contoh; model penjanaan belum disahkan · Pratonton untuk Speedcut Warisan Neon Zibo, berfokus pada persediaan adegan, laluan kamera, kesinambungan gerakan, butiran boleh diedit, dan bingkai hero akhir.
Pratonton video Speedcut Warisan Neon Zibo yang menunjukkan ritma gerakan, kesinambungan subjek, arahan kamera, dan bingkai hero akhir.
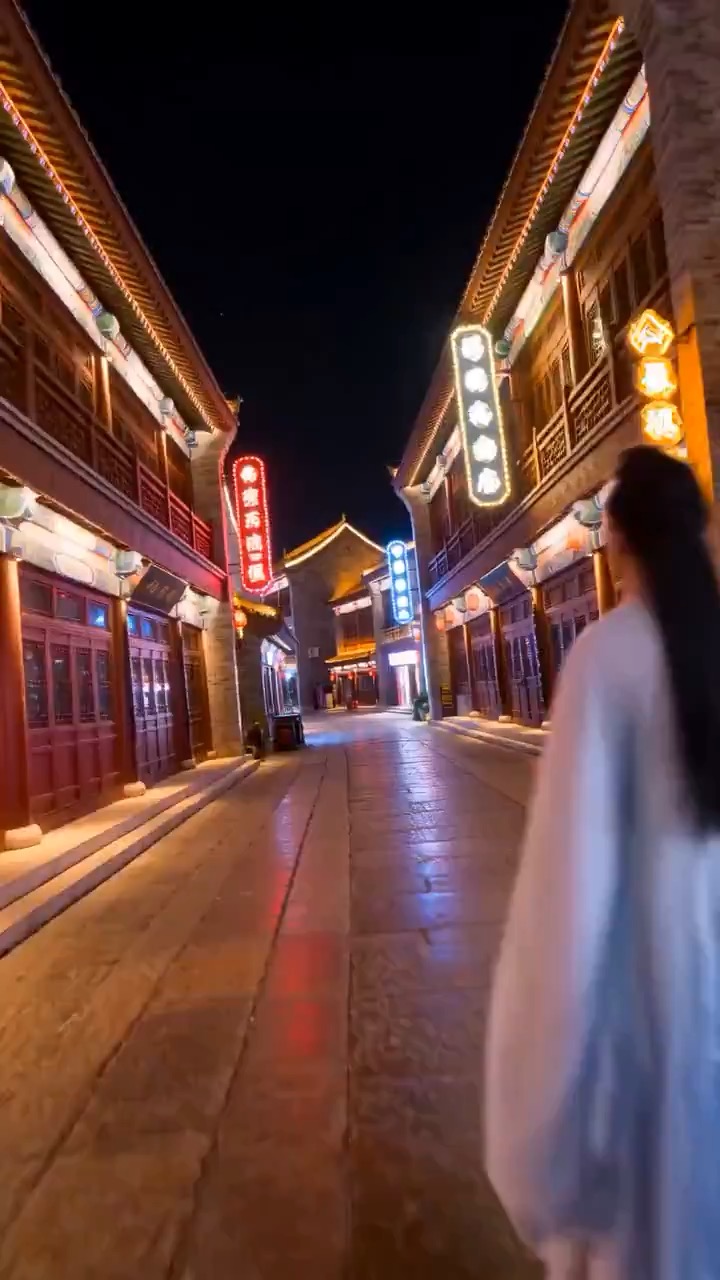
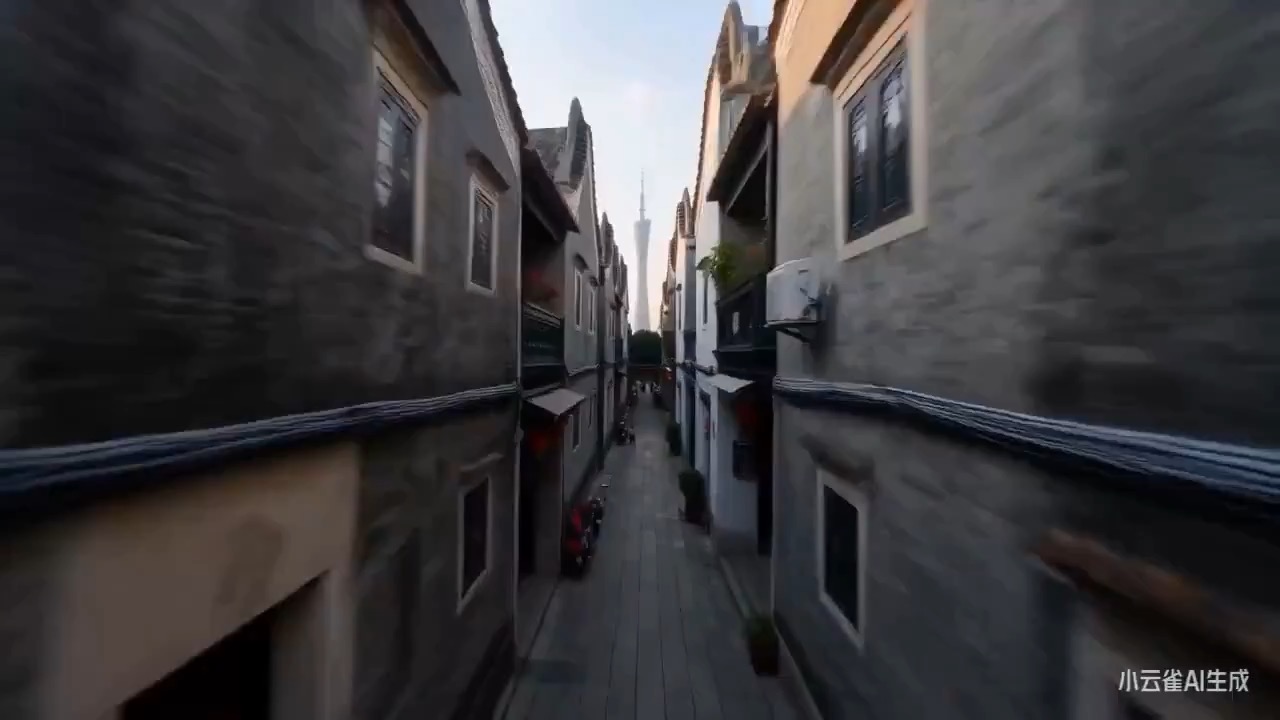
Contoh; model penjanaan belum disahkan · Pratonton one-take FPV cyber-warisan Guangzhou yang tertumpu pada logik kamera berterusan, tekstur Lingnan, neon sungai, dan skala mercu tanda yang stabil.
Pratonton video kota FPV Guangzhou dengan seni bina warisan, wap rumah teh, neon Pearl River, dan orbit Canton Tower.
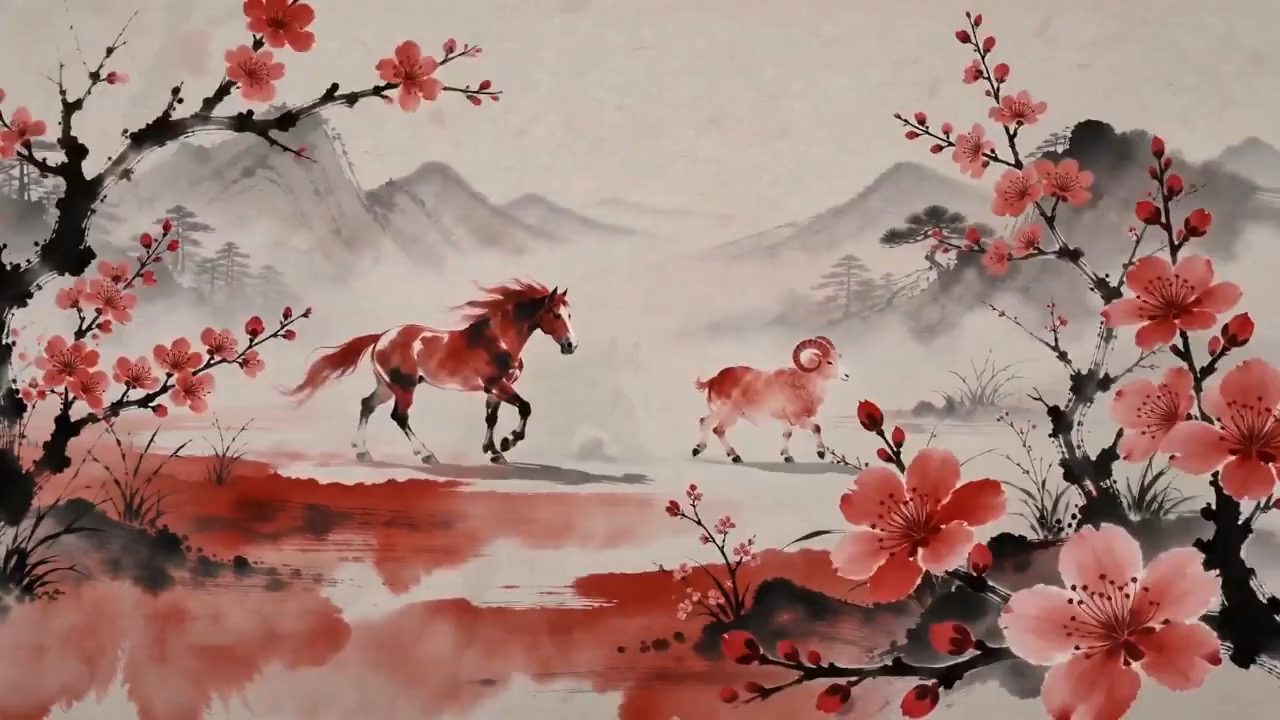
Contoh; model penjanaan belum disahkan · Klip pratonton untuk animasi duo skrol dakwat cinnabar, berfokus pada mekarnya dakwat, gerakan simbolik, ruang negatif, peralihan landskap dan penamat meterai boleh diedit.
Pratonton animasi 3D cat dakwat dengan figura bertuah cinnabar bergerak merentasi skrol kertas beras.
Contoh; model penjanaan belum disahkan · Penerbangan helang orang pertama melepasi halangan latar depan yang pecah, mengekalkan laluan keluar, dan terbuka kepada pemandangan luas penuh cahaya.
Pratonton video penerbangan melarikan diri POV helang dengan luncuran pantas yang boleh dibaca melalui batu runtuhan menuju cahaya terbuka.
Contoh; model penjanaan belum disahkan · Klip pratonton untuk prompt aksi watak rujukan, memfokuskan rentak adegan, ritma kamera, kesinambungan, dan detik hero akhir.
Pratonton video aksi watak rujukan yang menunjukkan gaya gerakan, arah kamera, dan ritma output untuk prompt ini.
Contoh; model penjanaan belum disahkan · Pratonton untuk Speedcut Warisan Neon Zibo, berfokus pada persediaan adegan, laluan kamera, kesinambungan gerakan, butiran boleh diedit, dan bingkai hero akhir.
Pratonton video Speedcut Warisan Neon Zibo yang menunjukkan ritma gerakan, kesinambungan subjek, arahan kamera, dan bingkai hero akhir.
Contoh; model penjanaan belum disahkan · Pratonton one-take FPV cyber-warisan Guangzhou yang tertumpu pada logik kamera berterusan, tekstur Lingnan, neon sungai, dan skala mercu tanda yang stabil.
Pratonton video kota FPV Guangzhou dengan seni bina warisan, wap rumah teh, neon Pearl River, dan orbit Canton Tower.
Contoh; model penjanaan belum disahkan · Klip pratonton untuk animasi duo skrol dakwat cinnabar, berfokus pada mekarnya dakwat, gerakan simbolik, ruang negatif, peralihan landskap dan penamat meterai boleh diedit.
Pratonton animasi 3D cat dakwat dengan figura bertuah cinnabar bergerak merentasi skrol kertas beras.
Laluan berpandukan imej-tambah-audio mengekalkan set kecil parameter lanjutan tersendiri dan tidak meruntuhkan semuanya kepada lalai
Ketiga-tiga laluan mengembalikan hasil melalui sejarah penjanaan tersimpan
Imej dan audio masih mengikut projek media risiko terendah yang sudah digunakan Rivya di tempat lain
Tugasan paling sesuai
Gunakannya apabila tugasan kelihatan seperti ini
Eksperimen Wan teks-ke-video yang lebih ringanMenjana klip pendek daripada satu imejKlip potret bercakap atau separa bercakap daripada satu imej pegun bersama satu fail audioPasukan yang mahukan peringkat video Wan lebih lama di bawah Wan 2.6Projek yang mahukan pintu masuk teks, imej, dan imej-tambah-audio di bawah satu model
Fakta ringkas
Input, output dan kredit untuk disahkan
Penyedia
Alibaba
Kategori
Video
Keupayaan
Teks ke Video · Imej ke Video · Dipacu Imej + Audio
Wan 2.2 A14B Turbo mempunyai mod Public API yang boleh dipanggil, tetapi mod media rujukan masih memerlukan sokongan muat naik Files API. Semak rujukan model sebelum menghantar.