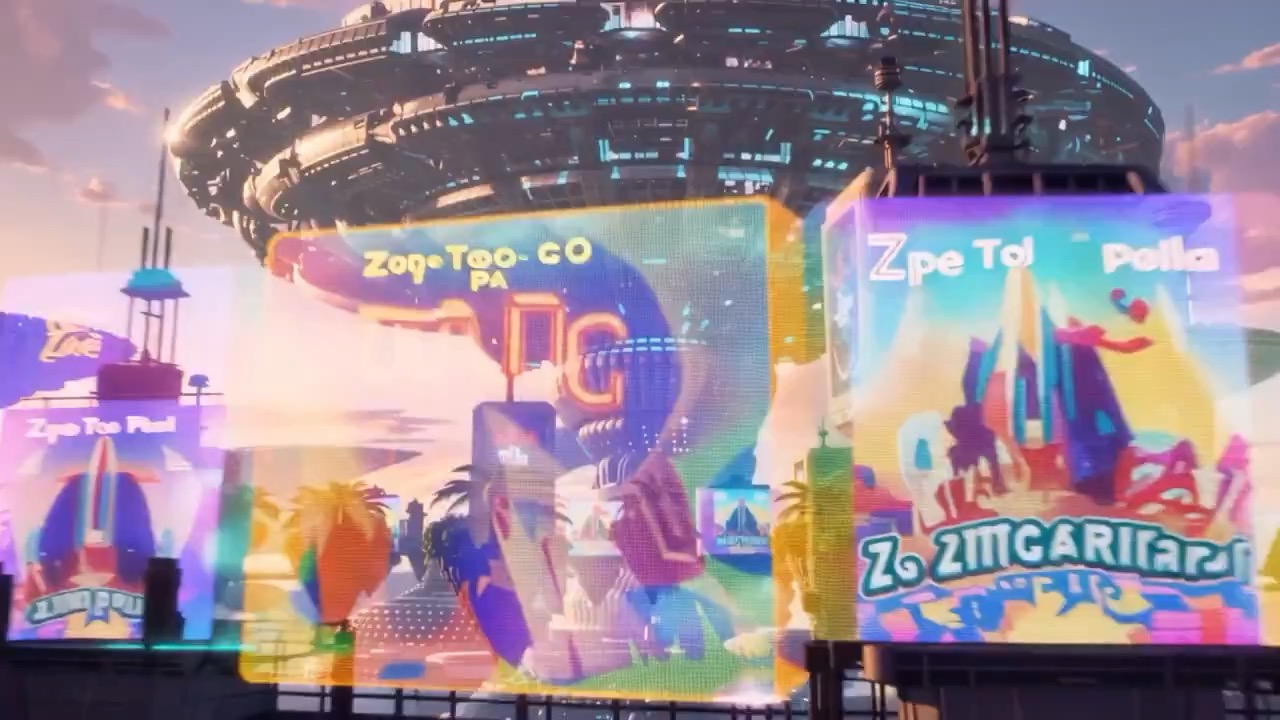Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor.
Tre tilstande: tekst-til-video + billede-til-video + video-til-videoEn tung Wan-løsning, der kan starte fra en kildevideo i stedet for kun tekst eller stillbilleder
Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil).
Video-til-video-redigeringer fra et eksisterende kildeklip
Eksempeloutput
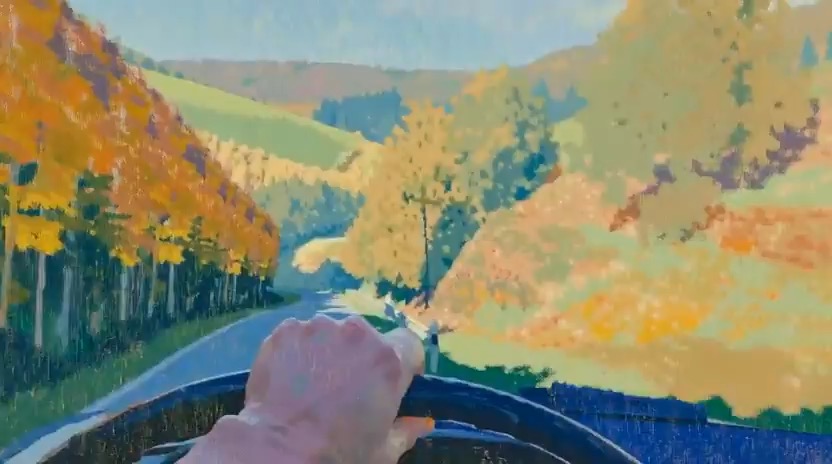
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til oliemalerisk køretur gennem skovklædte bakker med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Tjek først aktuel tilgængelighed, input, output, credits og dokumenteret output. Hvis en onlineprøve er tilgængelig, kan du teste modellen på siden. Brug Studio til gemt historik, aktiver og længere iteration.
Eksempeloutput
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til oliemalerisk køretur gennem skovklædte bakker med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Bedst til
Video-til-video-redigeringer fra et eksisterende kildeklipTekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.Animation af stillbilleder med et fleksibelt Wan-projektIterative bevægelsestests på tværs af tekst-, billed- og videoinput
Understøtter
Tekst til videoBillede til videoVideo til video
Onlineprøve
Brug Wan 2.6
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder. Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor.
Resultater
Intet resultat endnu. Indsend en prompt for at starte en kørsel.
Brug onlineprøven ovenfor, og sammenlign derefter disse eksempelresultater for at vurdere finish, rytme og opgavetilpasning, før du bruger flere credits i Studio.
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til oliemalerisk køretur gennem skovklædte bakker med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Videoforhåndsvisning af oliemalerisk køretur gennem skovklædte bakker med bevægelsesrytme, motivkontinuitet, kameraretning og endeligt hovedbillede.
Input
Op til 3 referencefiler
Hvad du skal lægge mærke til
Videoforhåndsvisning af oliemalerisk køretur gennem skovklædte bakker med bevægelsesrytme, motivkontinuitet, kameraretning og endeligt hovedbillede.
Tre tilstande: tekst-til-video + billede-til-video + video-til-video
En tung Wan-løsning, der kan starte fra en kildevideo i stedet for kun tekst eller stillbilleder
Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil).
Opgaver med bedst match
Opgaver med bedst match
Video-til-video-redigeringer fra et eksisterende kildeklipTekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.Animation af stillbilleder med et fleksibelt Wan-projektIterative bevægelsestests på tværs af tekst-, billed- og videoinput
Modeldokumentation
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til en solnedgangsoptagelse med orbital megastruktur med fokus på horisontopsætning, parallakseafsløring, læsbar skala, redigerbar farvetemperatur og det endelige hero-frame.
Forhåndsvisning af orbital megastruktur i solnedgang, der viser en rolig horisont, afsløring af buet struktur, blødt pink-blåt lys, kameradrift og endeligt bredt hero-frame.
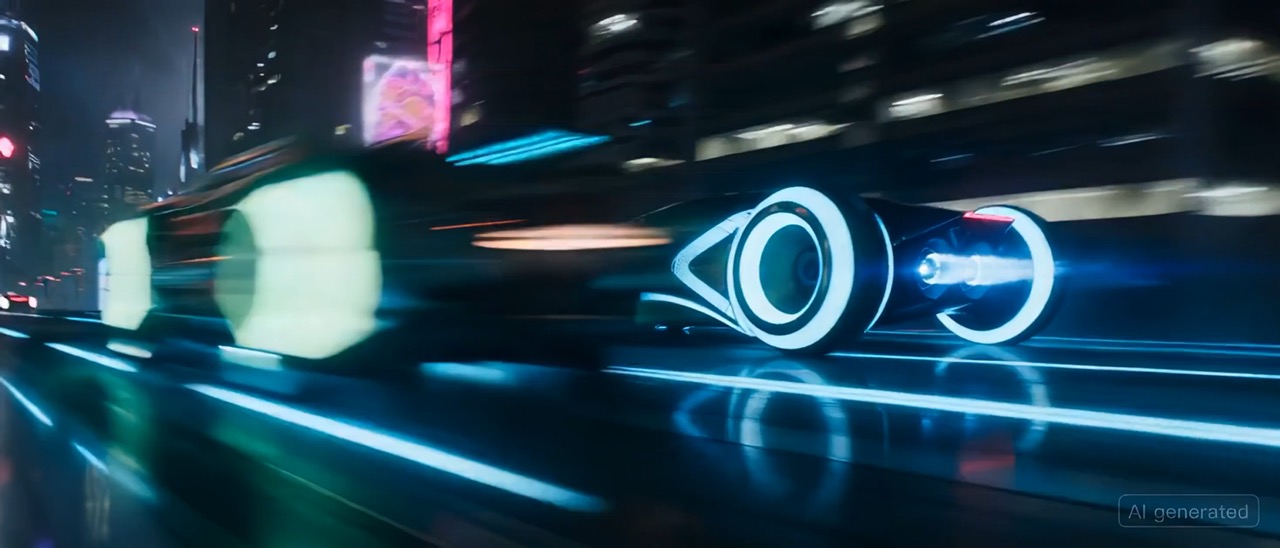
Eksempel; genererende model er ikke verificeret · Forhåndsvisning med fokus på hævet vejgeometri, nærpassage, trafikdybde, køretøjsskala og en læsbar bred slutning.
Sci-fi-videoforhåndsvisning af fremtidsby med en original speeder, der bevæger sig gennem lagdelt hævet trafik.
Beslutningstilpasning
Hvornår denne model er det rigtige valg
Beslutningstilpasning
Matchsignaler
Tre tilstande: tekst-til-video + billede-til-video + video-til-video
En tung Wan-løsning, der kan starte fra en kildevideo i stedet for kun tekst eller stillbilleder
Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil).
FAQ
Wan 2.6 FAQ
Hvilken type videoarbejde passer Wan 2.6 egentlig bedst til?
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.
Hvad omfatter Wan 2.6 reelt på Rivya lige nu?
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil). Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder. Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor.
Hvornår er Wan 2.6's forløb med kildevideo den egentlige grund til at vælge modellen?
Forløbet med kildevideo er den primære grund til at gå op til Wan 2.6, når det eksisterende klip allerede indeholder bevægelse, timing eller blokering, der er værd at bevare. Hvis dit stærkeste aktiv er selve klippet og ikke kun en skriftlig beskrivelse af optagelsen, er Wan 2.6 meget lettere at begrunde, fordi du styrer ud fra optagelser i stedet for at genopbygge scenen fra bunden.
Hvornår er Wan 2.6 sit nuværende credit-niveau værd?
Wan 2.6 koster i øjeblikket `720p 5s = 70`, `720p 10s = 140`, `720p 15s = 210`, `1080p 5s = 105`, `1080p 10s = 210` og `1080p 15s = 315` credits. Det niveau giver mening, når fleksibiliteten i sig selv sparer arbejde, især hvis den samme model dækker den første generering, bevægelse styret af stillbilleder og efterbearbejdning af kildevideo i én løsning. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.
Hvornår bør jeg vælge Wan 2.6 frem for Wan 2.7 eller en mere afgrænset løsning?
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.
Hvad kan jeg teste først på denne side?
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil).
Hvad kan jeg konfigurere på denne side?
Wan 2.6 understøtter tekst-til-video uden medier, billede-til-video med præcis ét billede og videoredigering med én til tre videoer; billeder og videoer kan ikke blandes. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder. Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor.
Hvilke kontroller er værd at foretage, før jeg starter kørslen?
Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor. Brug præcis 1 JPG/PNG/WebP-billede (mindst 256×256, højst 10 MB) eller 1–3 MP4/MOV-videoer (højst 10 MB pr. fil).
Skal jeg logge ind, før jeg kører her, og hvordan fungerer credits?
Siden er offentlig, men selve videokørslen kræver stadig, at du logger ind. Prisen følger i øjeblikket den synlige trappe: `720p 5s = 70`, `720p 10s = 140`, `720p 15s = 210`, `1080p 5s = 105`, `1080p 10s = 210` og `1080p 15s = 315` credits. Du kan først vælge det rette kildeforløb, varigheden og opløsningen og derefter logge ind, når du er klar til at starte kørslen. Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.
Hvornår bør jeg blive på denne side, og hvornår bør jeg gå videre til det fulde Studio?
Bliv her, mens du validerer det første kildeforløb og det første prisniveau på Wan 2.6. Åbn det fulde Studio, når arbejdet kræver gemte versioner, gentagne klipiterationer, flere koordinerede aktiver eller et længere styret projekt omkring de samme optagelser eller det samme scenesæt.
Sammenlign alternativer
Andre modeller at overveje næst
Video
Seedance 2.5
Seedance 2.5 er Rivyas større Seedance-arbejdsgang til video alene ud fra en prompt, vejledning med første og sidste ramme, multimodale referencer og videostyret transformation. Den tilføjer et 1080p-niveau, output på op til 30 sekunder, automatisk varighed, MP4- eller MOV-output og en væsentligt større kapacitet til billed-, video- og lydreferencer end Mini.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Op til 50 referencefiler.
ByteDances fulde Seedance 2.0-videomodel med tydelig understøttelse af prompt-only-generering, frame-styret animation og multimodal referencegenerering. Rivya holder den dokumenterede rolleopdeling tydelig, så frame-input og multimodale referencer forbliver gensidigt adskilte i stedet for at falde sammen i én uklar uploadspand.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer
Bedst tilKorte videoer i højere kvalitet fra prompts, frames eller referencepakker
Video
Seedance 2.0 Fast
ByteDances hurtigere Seedance 2.0-videomodel med fuld scene-routing til prompt-only-generering, frame-styret billedanimation og multimodal referencevideogenerering. Rivya holder den dokumenterede sceneopdeling tydelig, så første/sidste-frame-input ikke blandes sammen med rollerne for referencebilleder, video og lyd.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer
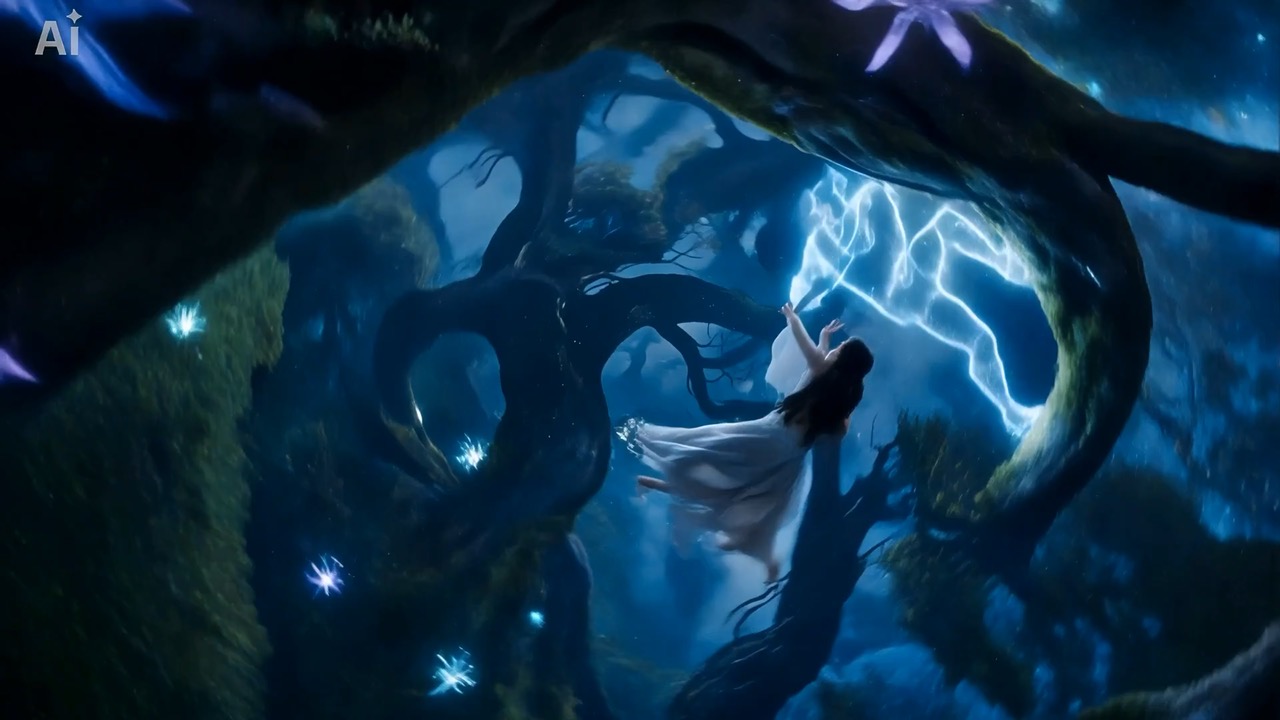
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til et brief om vandrer i midnatståget skov med fokus på tågedybde, figurbevægelse, diskret lys og afsluttende afsløringskomposition.
Videoforhåndsvisning af midnatståget skov med en kappeklædt vandrer, der bevæger sig gennem månebelyst dis.
Eksempel; genererende model er ikke verificeret · Preview af en håndtegnet pop-up-billedbogsoptagelse med fokus på sidevendingskontinuitet, håndlavet animation, udendørs lys og afsluttende bogkomposition.
Preview af håndtegnet pop-up-billedbogsvideo med animerede papirdyr, der rejser sig fra en åben bog.
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip med fokus på stibevægelse, raketskala, boarding-kontinuitet og lodret opsendelse.
Forhåndsvisning af skovactionvideo med en løber, der kommer ind i en lysning og letter i en kompakt raket.
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til en solnedgangsoptagelse med orbital megastruktur med fokus på horisontopsætning, parallakseafsløring, læsbar skala, redigerbar farvetemperatur og det endelige hero-frame.
Forhåndsvisning af orbital megastruktur i solnedgang, der viser en rolig horisont, afsløring af buet struktur, blødt pink-blåt lys, kameradrift og endeligt bredt hero-frame.
Eksempel; genererende model er ikke verificeret · Forhåndsvisning med fokus på hævet vejgeometri, nærpassage, trafikdybde, køretøjsskala og en læsbar bred slutning.
Sci-fi-videoforhåndsvisning af fremtidsby med en original speeder, der bevæger sig gennem lagdelt hævet trafik.
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til et brief om vandrer i midnatståget skov med fokus på tågedybde, figurbevægelse, diskret lys og afsluttende afsløringskomposition.
Videoforhåndsvisning af midnatståget skov med en kappeklædt vandrer, der bevæger sig gennem månebelyst dis.
Eksempel; genererende model er ikke verificeret · Preview af en håndtegnet pop-up-billedbogsoptagelse med fokus på sidevendingskontinuitet, håndlavet animation, udendørs lys og afsluttende bogkomposition.
Preview af håndtegnet pop-up-billedbogsvideo med animerede papirdyr, der rejser sig fra en åben bog.
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip med fokus på stibevægelse, raketskala, boarding-kontinuitet og lodret opsendelse.
Forhåndsvisning af skovactionvideo med en løber, der kommer ind i en lysning og letter i en kompakt raket.
Tekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.
Standard er 1080p, 5 sekunder, optagelsestilstand Fra og indholdsfilter Til. Begge indstillinger sendes eksplicit, og der genereres ikke et lydspor.
Opgaver med bedst match
Brug den, når opgaven ser sådan ud
Video-til-video-redigeringer fra et eksisterende kildeklipTekst- og billedinput understøtter 5, 10 eller 15 sekunder; videoinput understøtter kun 5 eller 10 sekunder.Animation af stillbilleder med et fleksibelt Wan-projektIterative bevægelsestests på tværs af tekst-, billed- og videoinputTeams, der har brug for én model til generering og efterbearbejdning af kildevideo
Rolige fakta
Input, output og credits at bekræfte
Udbyder
Alibaba
Kategori
Video
Evner
Tekst til video · Billede til video · Video til video
Wan 2.6 har Public API-tilstande, der kan kaldes, men referencemedietilstande kræver stadig Files API-uploadunderstøttelse. Tjek modelreferencen før indsendelse.