Kling AI Avatar Standard er Rivyas billigere AI-model til talende avatarer, når ét portrætbillede og ét lydklip skal blive til en læbesynkroniseret præsentationsvideo.
Fast portræt-plus-lyd-projekt til talende avatarer8 credits pr. sekund verificeret lyd, totalen rundes op
Ligefrem læbesynkroniseringsforløb
Input
1 billede + 1 lyd
Output
AI-videogenerator
Credits
per_input_second · default=8 · ⌈total⌉
Bedst til
Talende avatarvideoer
Eksempeloutput
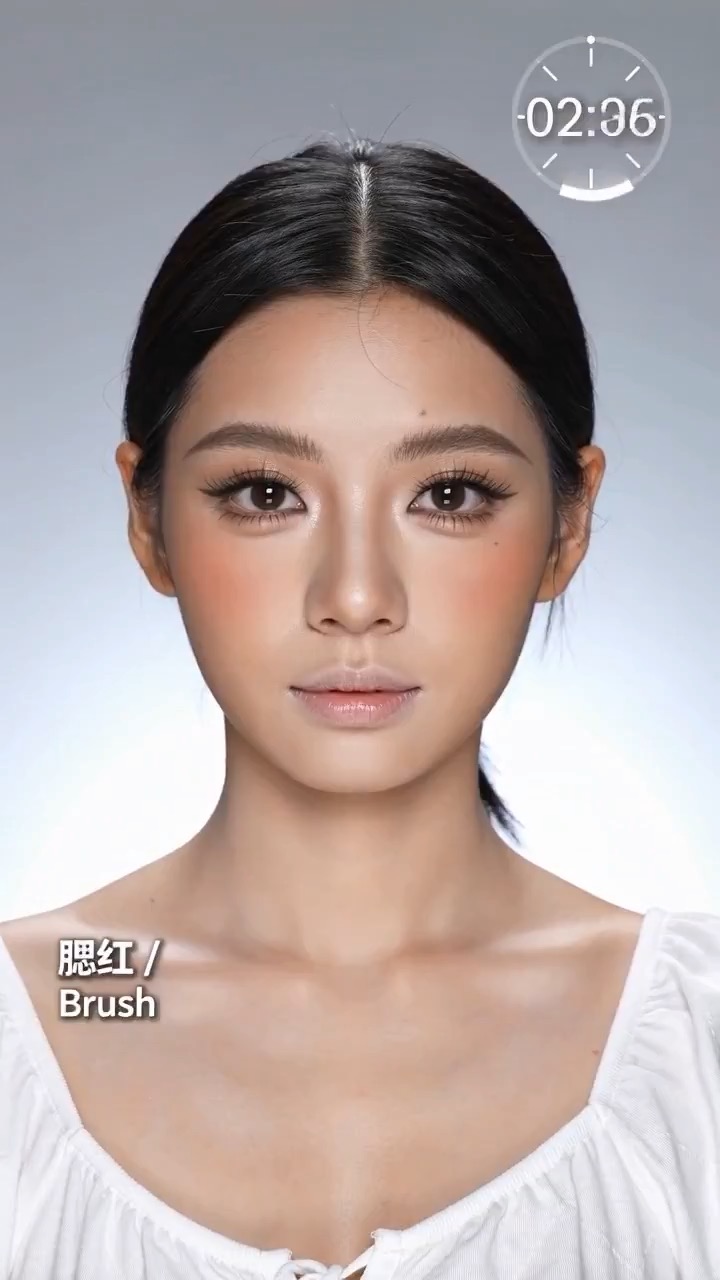
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til en hurtig makeup-transformation reel med fokus på læsbare beautybeats, identitetskontinuitet, ubrandede produkter og en poleret social-video-afslutning.
Læbesynkroniseret avatar · Drevet af billede + lyd
Tjek først aktuel tilgængelighed, input, output, credits og dokumenteret output. Hvis en onlineprøve er tilgængelig, kan du teste modellen på siden. Brug Studio til gemt historik, aktiver og længere iteration.
Eksempeloutput
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til en hurtig makeup-transformation reel med fokus på læsbare beautybeats, identitetskontinuitet, ubrandede produkter og en poleret social-video-afslutning.
Bedst til
Talende avatarvideoerKarakterbaserede forklaringsklipEnkle præsentationsvideoerKorte forklaringer med tale
Understøtter
Læbesynkroniseret avatarDrevet af billede + lyd
Onlineprøve
Prøv Kling AI Avatar Standard
Brug Kling AI Avatar Standard til billigere talende avatarvideoer fra ét portræt og ét lydklip.
Resultater
Intet resultat endnu. Indsend en prompt for at starte en kørsel.
Promptstartere
Start Kling AI Avatar Standard med en afprøvet prompt
Brug onlineprøven ovenfor, og sammenlign derefter disse eksempelresultater for at vurdere finish, rytme og opgavetilpasning, før du bruger flere credits i Studio.
Eksempel; genererende model er ikke verificeret · Forhåndsvisningsklip til en hurtig makeup-transformation reel med fokus på læsbare beautybeats, identitetskontinuitet, ubrandede produkter og en poleret social-video-afslutning.
Videoforhåndsvisning af hurtig makeup-transformation med en voksen beauty creator, ubrandet vanity table-opsætning, penselnærbillede, glidende overgang og poleret slutlook.
Input
1 billede + 1 lyd
Hvad du skal lægge mærke til
Videoforhåndsvisning af hurtig makeup-transformation med en voksen beauty creator, ubrandet vanity table-opsætning, penselnærbillede, glidende overgang og poleret slutlook.
Credits pr. brug
per_input_second · default=8 · ⌈total⌉
Hvorfor denne model virker
Hvorfor denne model virker
Fast portræt-plus-lyd-projekt til talende avatarer
8 credits pr. sekund verificeret lyd, totalen rundes op
Ligefrem læbesynkroniseringsforløb
Opgaver med bedst match
Opgaver med bedst match
Talende avatarvideoerKarakterbaserede forklaringsklipEnkle præsentationsvideoerKorte forklaringer med tale
Modeldokumentation
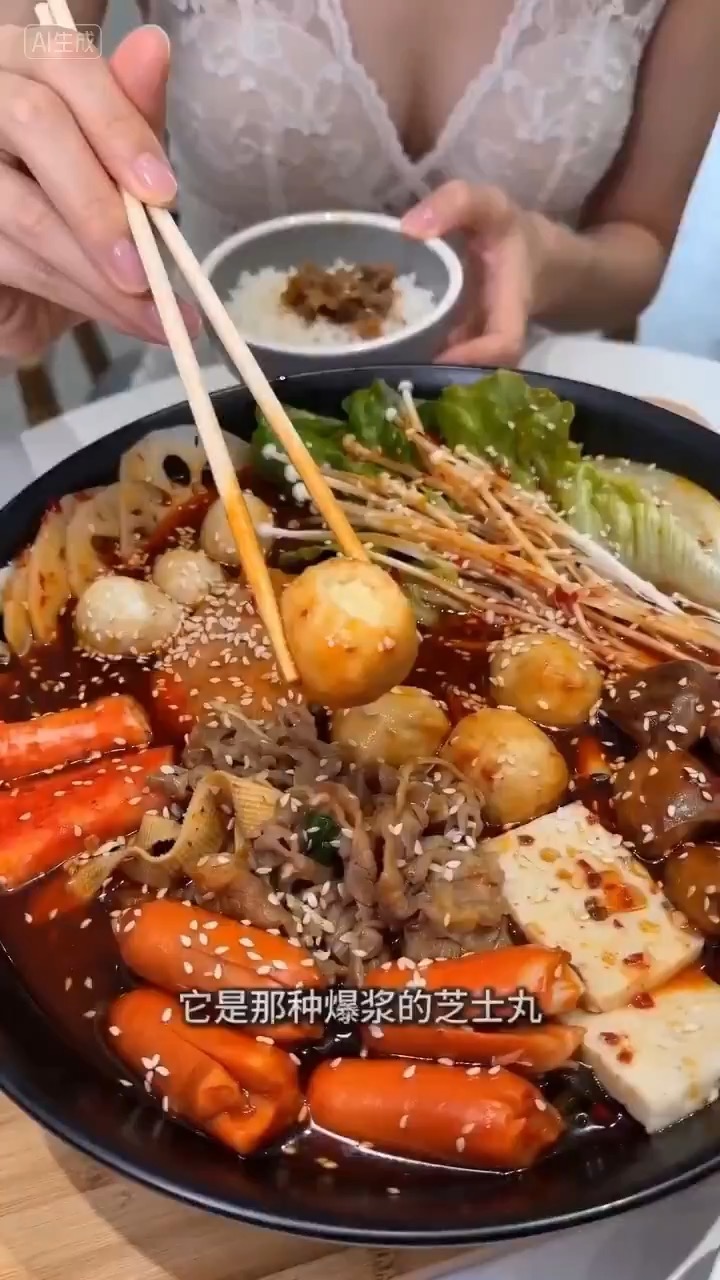
Eksempel; genererende model er ikke verificeret · Madværtsavatar præsenterer en redigerbar ret, smager den sikkert, reagerer naturligt og slutter med et rent billede af produkt og vært.
Videoforhåndsvisning af avatarvært til madsmagning med voksen præsentator, redigerbar ret, naturlig smagebevægelse og rent produktnærbillede.
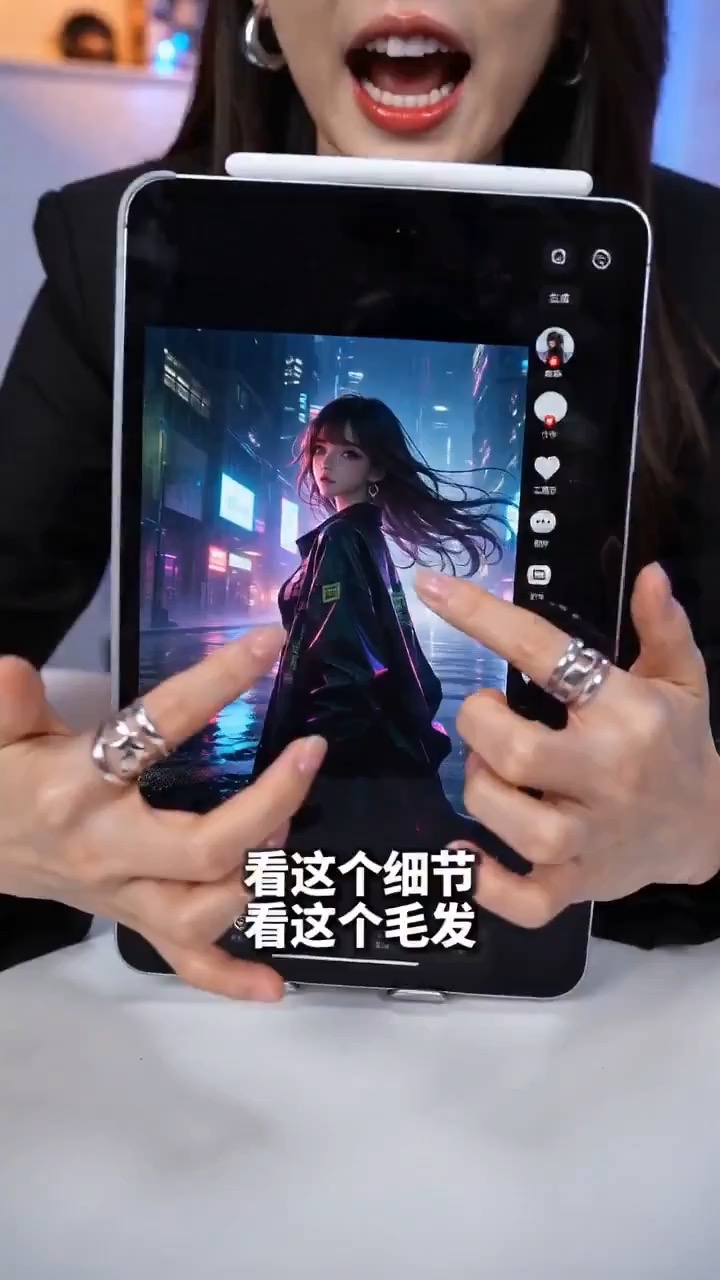
Eksempel; genererende model er ikke verificeret · Preview for en videobrief til live commerce-præsentator med fokus på sceneopsætning, kamerabane, kontinuitet i ansigtsbevægelse, redigerbare detaljer og den endelige hero-frame.
Preview af live commerce-produktdemo med præsentator, der viser bevægelsesrytme, motivkontinuitet, kameraretning og endelig hero-frame.
Beslutningstilpasning
Hvornår denne model er det rigtige valg
Beslutningstilpasning
Matchsignaler
Fast portræt-plus-lyd-projekt til talende avatarer
8 credits pr. sekund verificeret lyd, totalen rundes op
Ligefrem læbesynkroniseringsforløb
FAQ
Kling AI Avatar Standard FAQ
Hvilket videoarbejde passer Kling AI Avatar Standard faktisk bedst til?
Kling AI Avatar Standard passer bedst, når ét portræt og ét lydklip er nok til at bære hele opgaven. Den fungerer godt til enklere forklaringer med talende avatar, interne præsentationsvideoer og socialt indhold med lavere risiko, hvor Standard-prisen på 8 credits pr. sekund betyder mere end den mest polerede premium-finish.
Hvad er det reelle omfang for Kling AI Avatar Standard på Rivya lige nu?
På Rivya er denne mulighed bevidst fokuseret: ét portrætbillede, ét lydklip på op til 300 sekunder og en valgfri prompt. Den koster 8 credits pr. sekund verificeret lyd, og totalen rundes op til en hel credit.
Hvad betyder mest, når du vurderer, om Standard er nok?
Det største spørgsmål er normalt ikke dybden i indstillingerne, men kildekvaliteten. Hvis portrættet er rent, frontvendt og allerede ligner den præsentator, du vil beholde, og lyden er en brugbar endelig version, kan Standard være nok. Hvis arbejdet er mere brandfølsomt eller kræver et mere poleret avatarresultat, er det dér, Pro begynder at give mere mening.
Hvornår er Kling AI Avatar Standard sit nuværende credit-niveau værd?
Rivya opkræver 8 credits pr. sekund verificeret lyd, op til 300 sekunder, og runder totalen op til en hel credit. Standard-prisen passer til korte forklaringer, interne præsentationsklip og tidlige kundeudkast, som ikke kræver Pro-niveauets finish.
Hvornår bør jeg vælge Kling AI Avatar Standard frem for Pro eller en varighedsbaseret mulighed til talende video?
Vælg Kling AI Avatar Standard, når den lavere pris på 8 credits pr. sekund er nok, og outputtet ikke behøver at se særligt premium ud. For et mere poleret resultat i samme portræt-plus-lyd-format vælger du Kling AI Avatar Pro til 16 credits pr. sekund. Begge niveauer opkræves efter verificeret lydvarighed, op til 300 sekunder.
Hvad kan jeg teste først på denne side?
Start her, når det første resultat bare handler om at tjekke, om ét portræt og ét lydklip allerede kan bære et brugbart resultat med talende avatar. Brug den til interne forklaringer, enkle talspersonsklip og billigere avatarudkast, før du gør arbejdet til et mere fuldt produktionsforløb.
Hvad kan jeg sætte op på denne side?
Denne side er bygget omkring ét portrætbillede, ét lydklip og en valgfri prompt. Der er ingen tungere offentlig kontrolopsætning her, så det første resultat handler primært om at validere, om det valgte portræt og den valgte lyd allerede er stærke nok til en enkel læbesynkroniseret avatar-kørsel.
Hvilke tjek er værd at lave, før jeg trykker kør?
Før du kører, bør du sikre, at portrættet er frontvendt, at mundområdet er rent og ikke dækket, og at lyden er den version, du faktisk vil beholde. På denne model betyder kildekvaliteten mere end parameterjustering, fordi siden med vilje er letvægtig.
Skal jeg logge ind, før jeg kører her, og hvordan fungerer credits?
Siden er offentlig, men den faktiske avatargenerering kræver stadig login. Rivya opkræver 8 credits pr. sekund verificeret lyd, højst 300 sekunder, og runder totalen op; du kan forberede portrættet, lyden og grundtonen, før du logger ind.
Hvornår bør jeg blive på denne side, og hvornår bør jeg gå ind i det fulde Studio?
Bliv på denne side, mens du tjekker ét portræt-lyd-par og vurderer, om Standard er godt nok til opgaven. Åbn det fulde Studio, når projektet har brug for gemte versioner, flere avatar-materialer, gentagne revisioner eller et længere produktionsforløb omkring den samme præsentator.
Sammenlign alternativer
Andre modeller at overveje næst
Video
Seedance 2.5
Seedance 2.5 er Rivyas større Seedance-arbejdsgang til video alene ud fra en prompt, vejledning med første og sidste ramme, multimodale referencer og videostyret transformation. Den tilføjer et 1080p-niveau, output på op til 30 sekunder, automatisk varighed, MP4- eller MOV-output og en væsentligt større kapacitet til billed-, video- og lydreferencer end Mini.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Op til 50 referencefiler.
ByteDances fulde Seedance 2.0-videomodel med tydelig understøttelse af prompt-only-generering, frame-styret animation og multimodal referencegenerering. Rivya holder den dokumenterede rolleopdeling tydelig, så frame-input og multimodale referencer forbliver gensidigt adskilte i stedet for at falde sammen i én uklar uploadspand.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer
Bedst tilKorte videoer i højere kvalitet fra prompts, frames eller referencepakker
Video
Seedance 2.0 Fast
ByteDances hurtigere Seedance 2.0-videomodel med fuld scene-routing til prompt-only-generering, frame-styret billedanimation og multimodal referencevideogenerering. Rivya holder den dokumenterede sceneopdeling tydelig, så første/sidste-frame-input ikke blandes sammen med rollerne for referencebilleder, video og lyd.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer
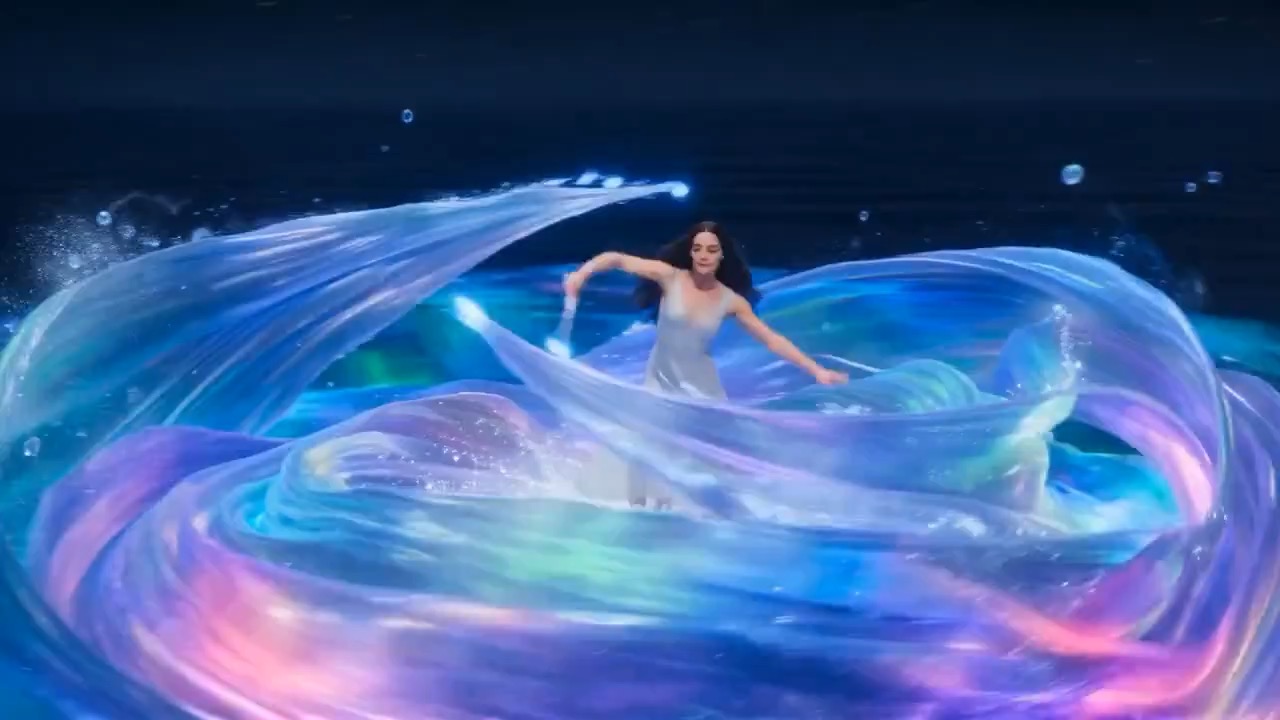
Eksempel; genererende model er ikke verificeret · En redigerbar danser bevæger sig gennem glødende havvand, tegner lys med hvert trin og slutter i en rolig månebelyst positur.
Forhåndsvisning af fantasy-avatar til havdans med månebelyste bølger, glødende vandspor og en balanceret slutpositur.
Prompten er valgfri
Nyttig til at genskabe eller supplere legacy Avatar-projekter
Opgaver med bedst match
Brug den, når opgaven ser sådan ud
Talende avatarvideoerKarakterbaserede forklaringsklipEnkle præsentationsvideoerKorte forklaringer med taleSammenligningstest med legacy Avatar
Rolige fakta
Input, output og credits at bekræfte
Udbyder
Kuaishou
Kategori
Video
Evner
Læbesynkroniseret avatar · Drevet af billede + lyd