Infinitalk er Rivyas lyddrevne generator til talende video, der forvandler ét portrætbillede og ét lydklip til avatarfortælling, podcast-til-video eller forklarende klip.
Fast projekt til talende video med portræt plus lydCredits følger opløsning og verificeret lydvarighedUnderstøtter 480p- og 720p-outputtrin
Input
1 billede + 1 lyd
Output
AI-videogenerator
Credits
per_input_second · 480p=3 · 720p=12 · ⌈total⌉
Bedst til
Talende avatarvideoer
Eksempeloutput
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til debat på moderskib ved ormehul med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Læbesynkroniseret avatar · Drevet af billede + lyd
Tjek først aktuel tilgængelighed, input, output, credits og dokumenteret output. Hvis en onlineprøve er tilgængelig, kan du teste modellen på siden. Brug Studio til gemt historik, aktiver og længere iteration.
Eksempeloutput
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til debat på moderskib ved ormehul med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Brug onlineprøven ovenfor, og sammenlign derefter disse eksempelresultater for at vurdere finish, rytme og opgavetilpasning, før du bruger flere credits i Studio.
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til debat på moderskib ved ormehul med fokus på sceneopsætning, kamerasti, bevægelseskontinuitet, redigerbare detaljer og det endelige hovedbillede.
Videoforhåndsvisning af debat på moderskib ved ormehul med bevægelsesrytme, motivkontinuitet, kameraretning og endeligt hovedbillede.
Input
1 billede + 1 lyd
Hvad du skal lægge mærke til
Videoforhåndsvisning af debat på moderskib ved ormehul med bevægelsesrytme, motivkontinuitet, kameraretning og endeligt hovedbillede.
Credits pr. brug
per_input_second · 480p=3 · 720p=12 · ⌈total⌉
Hvorfor denne model virker
Hvorfor denne model virker
Fast projekt til talende video med portræt plus lyd
Credits følger opløsning og verificeret lydvarighed
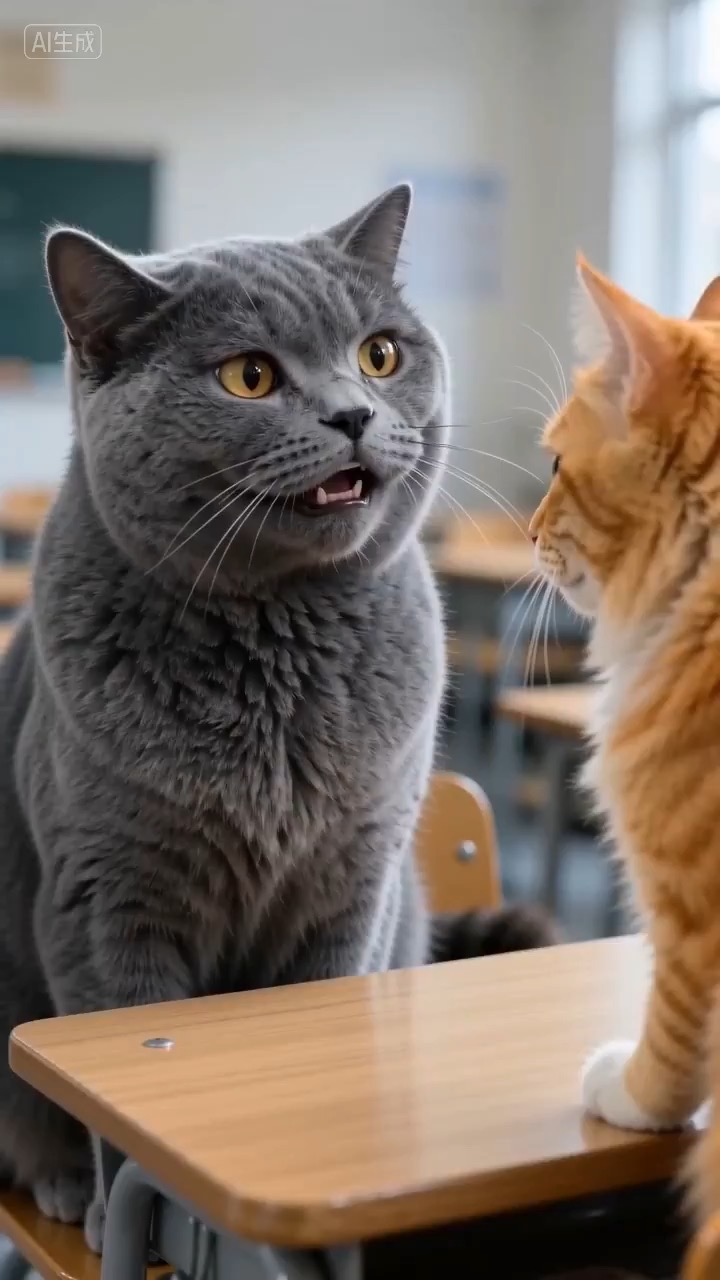
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til en talende avatar med klasseværelsesreaktion med fokus på taleropsætning, dialogbeat, reaktionstiming, redigerbare detaljer og final frame.
Forhåndsvisning af talende avatar med klasseværelsesreaktion, der viser naturlig ansigtsbevægelse, lip-sync-timing, stabil framing og final frame.
Eksempel; genererende model er ikke verificeret · Preview for en gadeselfie-brief ved månenytår med fokus på præsentatoropsætning, festlig baggrund, læbesynk-kontinuitet, redigerbar hilsentekst og endelig hero-frame.
Preview af gadeselfie ved månenytår med voksen præsentator, festlige lys, stabil håndholdt framing, naturlig læbesynk og endelig afslutningsframe.
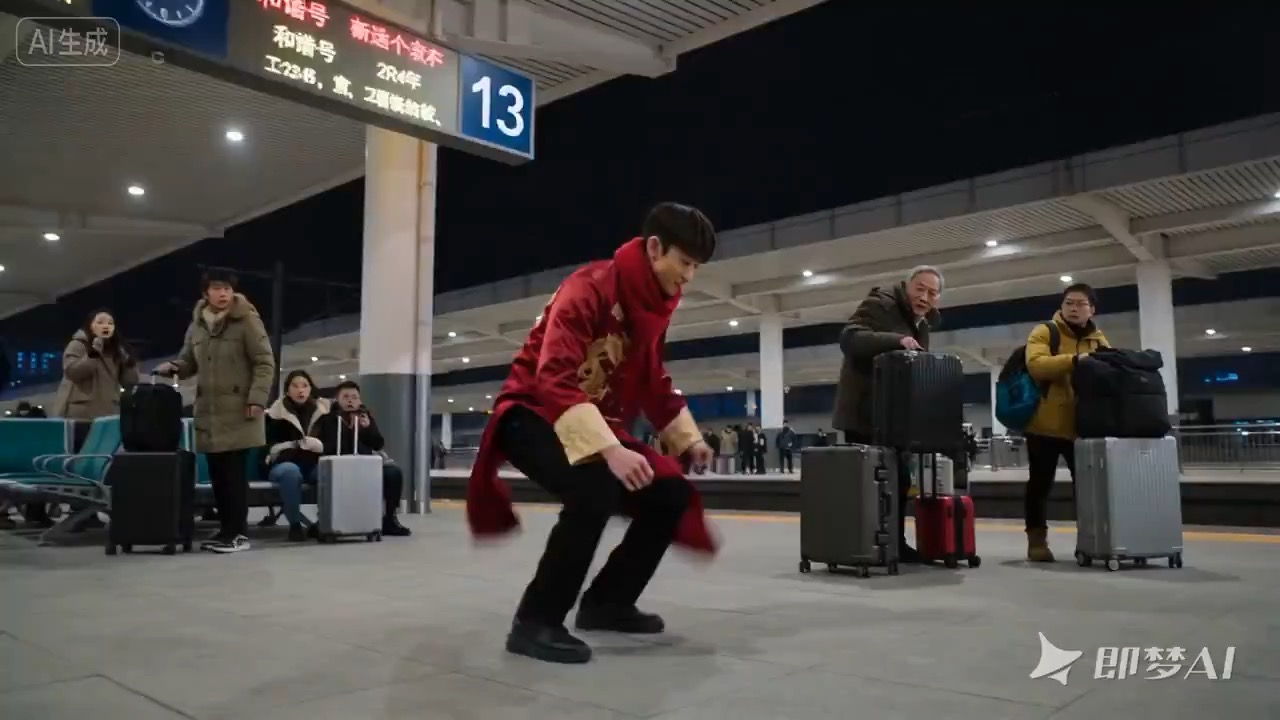
Eksempel; genererende model er ikke verificeret · Forhåndsvisning til kort gadefilm med reaktion fra rejsende med fokus på sceneopsætning, kamerarute, bevægelseskontinuitet, redigerbare detaljer og afsluttende hovedbillede.
Videoforhåndsvisning af kort gadefilm med reaktion fra rejsende, der viser bevægelsesrytme, subjektkontinuitet, kameraretning og afsluttende hovedbillede.
Beslutningstilpasning
Hvornår denne model er det rigtige valg
Beslutningstilpasning
Matchsignaler
Fast projekt til talende video med portræt plus lyd
Credits følger opløsning og verificeret lydvarighed
Understøtter 480p- og 720p-outputtrin
God til podcasts, forklaringer og avatarfortælling
Fungerer godt til varighedsbaserede kørsler med talende video
Læbesynkroniseret avatar · Drevet af billede + lyd
Creditmodel
per_input_second · 480p=3 · 720p=12 · ⌈total⌉
Inputvej
1 billede + 1 lyd
Promptopsætning
Op til 5,000 tegn
FAQ
Infinitalk FAQ
Hvornår bør jeg bruge Infinitalk til videoarbejde?
Infinitalk er stærkest, når ét portræt og ét færdigt lydspor allerede driver opgaven. Den passer til forklaringsvideoer med talende avatar, podcast-til-video-klip og fortællingsstyrede karakterklip, når lyden skal være timingankeret, og outputomkostningen skal skalere med varighed i stedet for et fast gebyr pr. kørsel.
Hvad er Infinitalks reelle omfang på Rivya lige nu?
På Rivya er denne mulighed bygget omkring præcis ét portrætbillede, ét lydklip, en påkrævet prompt og to offentlige kontroller: opløsning og seed. Prisen følger i øjeblikket verificeret lydvarighed med 480p til 3 credits pr. sekund og 720p til 12 credits pr. sekund, hvilket gør det til et varighedsstyret projekt til talende video frem for en generisk billede-til-video-model.
Hvilke kontroller eller input betyder mest, når du evaluerer Infinitalk til reelt arbejde?
De vigtigste spørgsmål er, om portrættet er frontvendt og rent nok til avataroplæsningen, om lydsporet allerede er den optagelse, du vil beholde, og om 480p eller 720p er berettiget til opgaven. Seed betyder først for alvor noget, hvis du har brug for reproducerbarhed; den reelle beslutning ligger oftest i kildeportrættet, kildelyden og afvejningen mellem opløsning og omkostning.
Hvornår er Infinitalk værd at bruge det aktuelle prisniveau i credits på Rivya?
Rivya viser i øjeblikket 3 credits pr. sekund ved 480p og 12 credits pr. sekund ved 720p. Det er lettest at retfærdiggøre, når du allerede har et færdigt stemmespor og vil have videoomkostningen til at skalere med den faktiske talte varighed i stedet for at betale et fast avatar-gebyr for hver kørsel.
Hvornår bør jeg vælge Infinitalk frem for et lettere eller billigere alternativ på Rivya?
Vælg Kling AI Avatar Standard, når den lavere pris på 8 credits pr. sekund er nok, og outputtet ikke behøver at se særligt premium ud. For et mere poleret resultat i samme portræt-plus-lyd-format vælger du Kling AI Avatar Pro til 16 credits pr. sekund. Begge niveauer opkræves efter verificeret lydvarighed, op til 300 sekunder. På Rivya er denne mulighed bygget omkring præcis ét portrætbillede, ét lydklip, en påkrævet prompt og to offentlige kontroller: opløsning og seed. Prisen følger i øjeblikket verificeret lydvarighed med 480p til 3 credits pr. sekund og 720p til 12 credits pr. sekund, hvilket gør det til et varighedsstyret projekt til talende video frem for en generisk billede-til-video-model.
Hvad kan jeg teste først på denne side?
Start her, når det første resultat skal svare på, om ét portræt og én lydfil allerede kan bære en troværdig talende video. Brug den til forklaringer, podcast-til-video-tests og fortællingsstyrede avatarklip, når lyden allerede er klar.
Hvad kan jeg sætte op på denne side?
Denne side er bygget omkring ét portrætbillede, ét lydklip, en påkrævet prompt samt opløsning og seed. Den er ikke en generel animationsflade; det første resultat handler reelt om at validere ét portræt-plus-lyd-par.
Hvilke kontroller er værd at tjekke, før jeg starter?
Før du starter, skal du sikre, at portrættet er frontvendt og rent, at lyden er den optagelse, du vil beholde, og at opløsningsvalget matcher budgettet. Start med 480p, når du kun validerer adfærden i den talende video, og gå til 720p, når et klarere præsentatoroutput er den langt højere pris pr. sekund værd.
Skal jeg logge ind, før jeg kører her, og hvordan fungerer credits?
Siden er offentlig, men den faktiske første billedstyrede videokørsel kræver stadig login. Rivya viser i øjeblikket 3 credits pr. sekund ved 480p og 12 credits pr. sekund ved 720p, så du kan først gøre portræt, lyd og varighedsforventninger klar og derefter logge ind, når du er klar til at generere.
Hvornår bør jeg blive på denne side, og hvornår bør jeg gå videre til det fulde Studio?
Bliv på denne side, mens du tjekker ét portræt-lyd-par og vurderer, om den første talende version er nok. Åbn det fulde Studio, når arbejdet kræver gemte versioner, flere avatarfiler eller et længere produktionsforløb omkring den samme karakter.
Sammenlign alternativer
Andre modeller at overveje næst
Video
Seedance 2.5
Seedance 2.5 er Rivyas større Seedance-arbejdsgang til video alene ud fra en prompt, vejledning med første og sidste ramme, multimodale referencer og videostyret transformation. Den tilføjer et 1080p-niveau, output på op til 30 sekunder, automatisk varighed, MP4- eller MOV-output og en væsentligt større kapacitet til billed-, video- og lydreferencer end Mini.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Op til 50 referencefiler.
ByteDances fulde Seedance 2.0-videomodel med tydelig understøttelse af prompt-only-generering, frame-styret animation og multimodal referencegenerering. Rivya holder den dokumenterede rolleopdeling tydelig, så frame-input og multimodale referencer forbliver gensidigt adskilte i stedet for at falde sammen i én uklar uploadspand.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer
ByteDances hurtigere Seedance 2.0-videomodel med fuld scene-routing til prompt-only-generering, frame-styret billedanimation og multimodal referencevideogenerering. Rivya holder den dokumenterede sceneopdeling tydelig, så første/sidste-frame-input ikke blandes sammen med rollerne for referencebilleder, video og lyd.
Hvorfor overveje den
Overvej den, når din næste opgave kræver Prompt, frames eller billed-/video-/lydreferencer.
InputPrompt, frames eller billed-/video-/lydreferencer